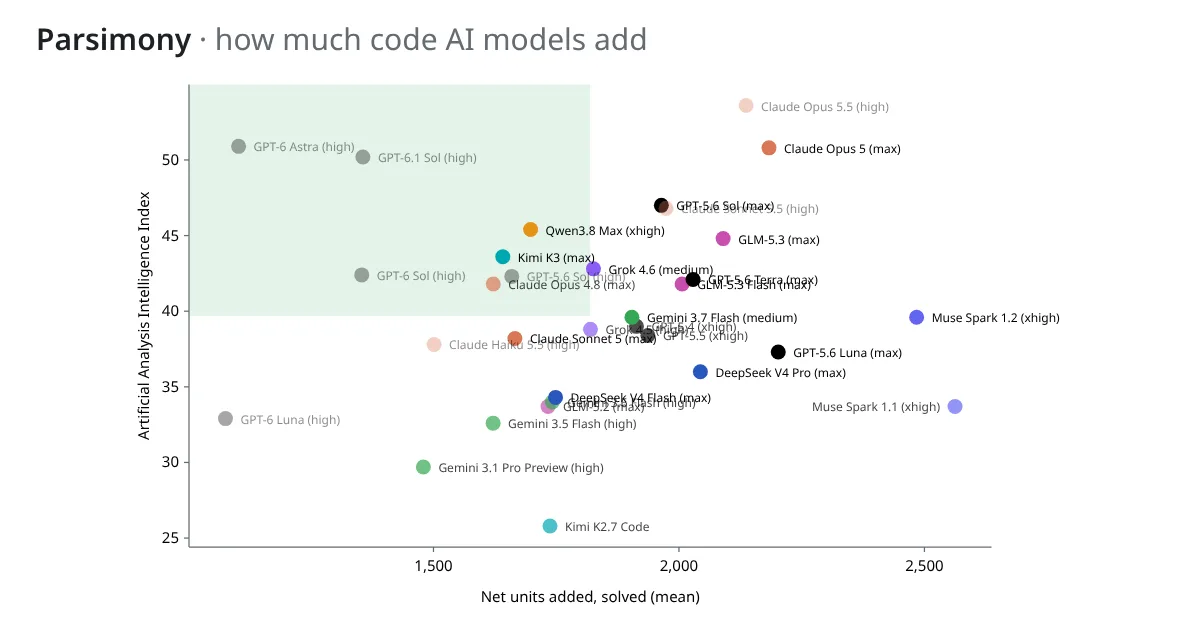
Các tiêu chuẩn đánh giá model AI hiện nay chủ yếu tập trung vào tỷ lệ giải quyết bài toán và chi phí vận hành, nhưng lại bỏ qua lượng mã thừa do AI tạo ra, khiến codebase trở nên cồng kềnh. Để giải quyết bài toán này, Parsimony đã ra mắt như một benchmark mã nguồn mở chuyên đo lường lượng code thực tế mà các mô hình AI cộng thêm vào dự án.
Thay vì đếm số dòng code dễ bị lợi dụng bởi việc dồn nén cú pháp, Parsimony đếm các đơn vị lập trình thực tế như câu lệnh, biểu thức gọi hàm, phép so sánh và từ khóa. Công cụ tính toán theo công thức đơn vị ròng bằng phần mã thêm vào trừ đi phần mã bị xóa, qua đó xếp hạng các model dựa trên độ tinh gọn và hiệu quả xử lý trong các tác vụ lập trình.
Benchmark này tận dụng các bản vá từ các tập dữ liệu có sẵn như SWE-bench Verified và cho phép các lập trình viên dễ dàng chạy thử nghiệm trên trình duyệt cá nhân. Việc đánh giá chi tiết này mang lại góc nhìn thực tế hơn về khả năng viết code sạch của các hệ thống AI.
Đối với cộng đồng lập trình viên và kỹ sư AI tại Việt Nam, Parsimony cung cấp một tiêu chí tham khảo vô cùng giá trị khi lựa chọn model hỗ trợ lập trình. Việc hạn chế code rác giúp các dự án phần mềm duy trì tính dễ đọc, dễ bảo trì và tối ưu chi phí vận hành trong dài hạn.
Nguồn: Hacker News — Biên dịch & tổng hợp: danhbaai.com