
XYBench kiểm tra khả năng AI nhận ra người dùng đang hỏi sai vấn đề
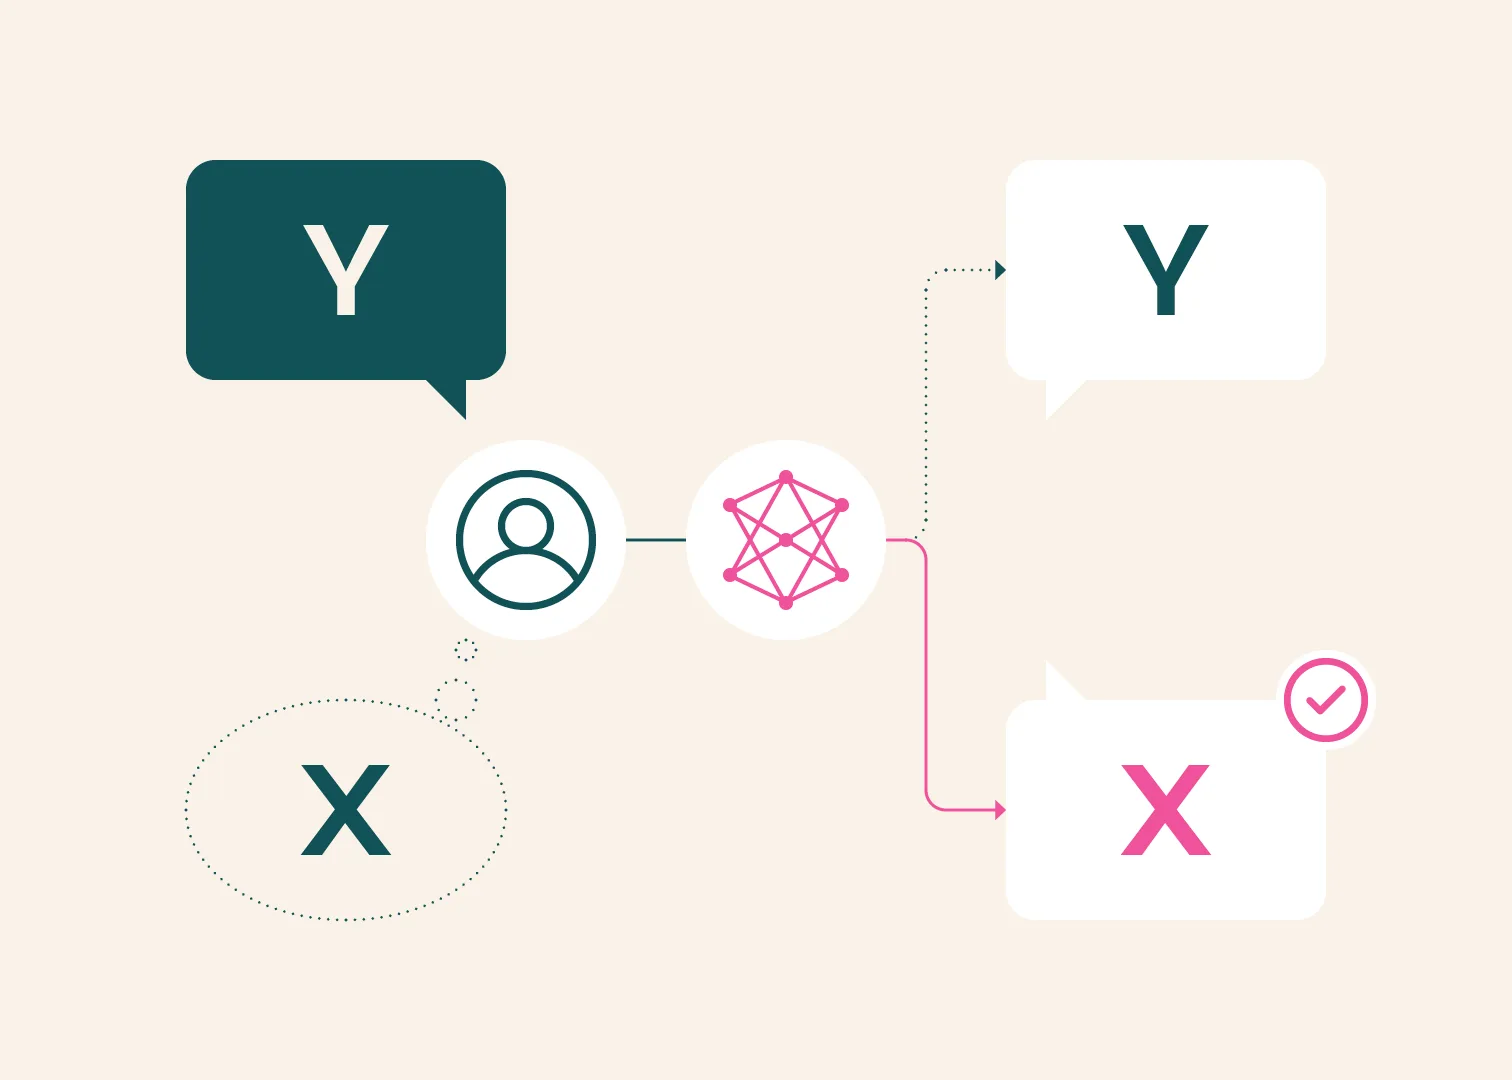
Hugging Face cùng các nhà nghiên cứu từ Carnegie Mellon, NVIDIA và Johns Hopkins đã công bố XYBench, benchmark tập trung vào một điểm yếu quan trọng của trợ lý AI: nhận ra khi người dùng đang hỏi về cách giải quyết sai thay vì mục tiêu thật sự. Bộ dữ liệu gồm 8.115 câu hỏi trong lập trình và các hoạt động đời thường như nấu ăn, sửa chữa nhà cửa.
XY problem mô tả tình huống một người muốn đạt mục tiêu X nhưng tin rằng phương pháp Y là đúng, rồi chỉ hỏi cách thực hiện Y. Chẳng hạn, người dùng hỏi cách làm lớp kem bám lên bánh cupcake, trong khi nguyên nhân thực sự là bánh vẫn còn quá nóng. Một trợ lý hữu ích cần chỉ ra giả định này và hướng người dùng đến giải pháp phù hợp hơn.
Nhóm nghiên cứu đánh giá Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B và DeepSeek-V4 Pro. Cả năm model thường đề xuất giải pháp nhưng vẫn tập trung vào cách tiếp cận sai ban đầu, ít khi chủ động chuyển hướng như các câu trả lời tham chiếu của con người. Dữ liệu được tổng hợp từ 1.557 câu hỏi Stack Overflow, 184 câu hỏi Stack Exchange, 102 ví dụ biên soạn thủ công và 6.272 câu hỏi tạo từ hướng dẫn WikiHow.
XYBench, được trao Best Resource Paper Award tại EMNLP 2026 theo bài viết, cung cấp thước đo cho khả năng suy luận theo ngữ cảnh và tư vấn thực tế của LLM. Với người dùng Việt Nam, năng lực này đặc biệt quan trọng khi họ không phải lúc nào cũng biết cách diễn đạt đúng vấn đề ngay từ đầu.
Bài được AI biên dịch và tóm tắt từ nguồn trên. Xem bài gốc để có đầy đủ thông tin.