
Một kỹ thuật lập trình mới tận dụng xác suất log (logprobs) của mô hình ngôn ngữ lớn (LLM) vừa được chia sẻ, cho phép tối ưu hóa đáng kể tốc độ và chi phí khi thực hiện các tác vụ phân loại dữ liệu, bao gồm cả mô hình thị giác đa phương thức.
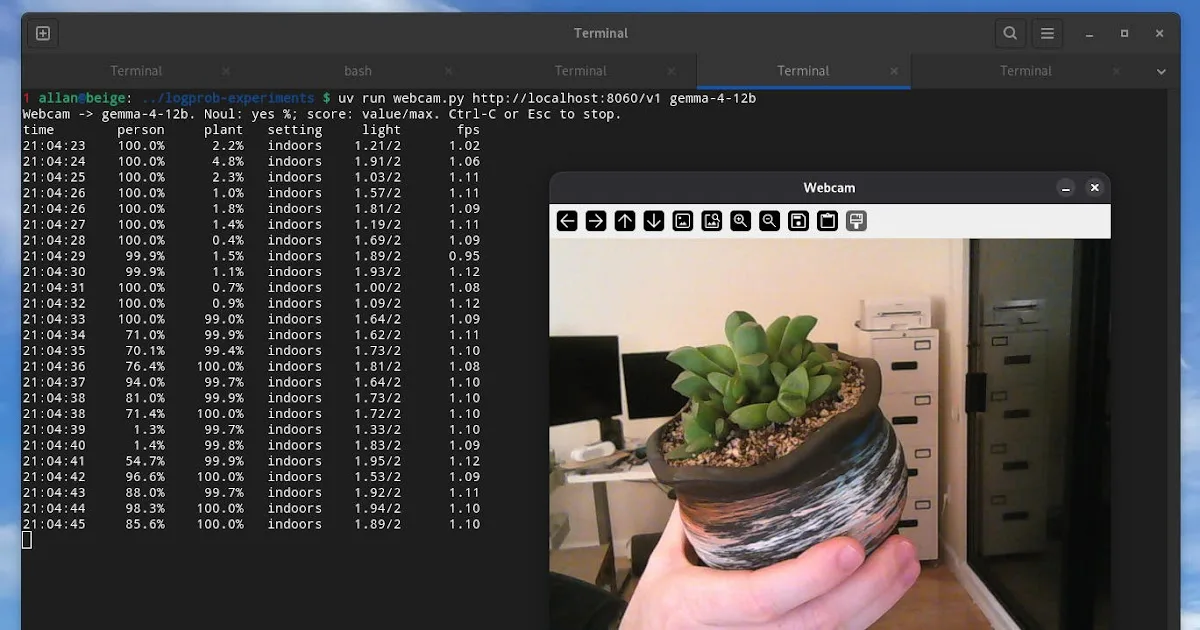
Bằng cách giới hạn số lượng token sinh ra ở mức tối đa 1 token kết hợp với các tham số logprobs: true và top_logprobs, nhà phát triển có thể buộc LLM đưa ra câu trả lời dưới dạng ký tự đơn và đọc xác suất của các phương án thay thế. Kỹ thuật này loại bỏ hoàn toàn quá trình sinh văn bản dài dòng, từ đó giảm thiểu đáng kể độ trễ phản hồi của hệ thống. Đồng thời, cấu trúc dữ liệu Jev được mở rộng thêm trường tệp đính kèm để gửi hình ảnh mã hóa base64 từ webcam đến các mô hình đa phương thức.
Trong thử nghiệm thực tế với mô hình Gemma 12B chạy cục bộ trên GPU RTX 3090, hệ thống đạt tốc độ xử lý khoảng 1 khung hình trên giây cho 3 câu hỏi đánh giá đồng thời về sự xuất hiện của con người, không gian trong nhà hay ngoài trời và độ sáng của khung hình. Dù các mô hình thị giác chuyên dụng có hiệu suất cao hơn, phương pháp này mang lại sự linh hoạt vượt trội khi cho phép người dùng thay đổi tiêu chí đánh giá hoàn toàn bằng ngôn ngữ tự nhiên.
Giải pháp này mang lại gợi ý giá trị cho cộng đồng phát triển AI tại Việt Nam trong việc tối ưu hóa chi phí gọi API và giảm độ trễ khi tích hợp khả năng xử lý hình ảnh vào các ứng dụng thực tế.
Nguồn: Hacker News — Biên dịch & tổng hợp: danhbaai.com