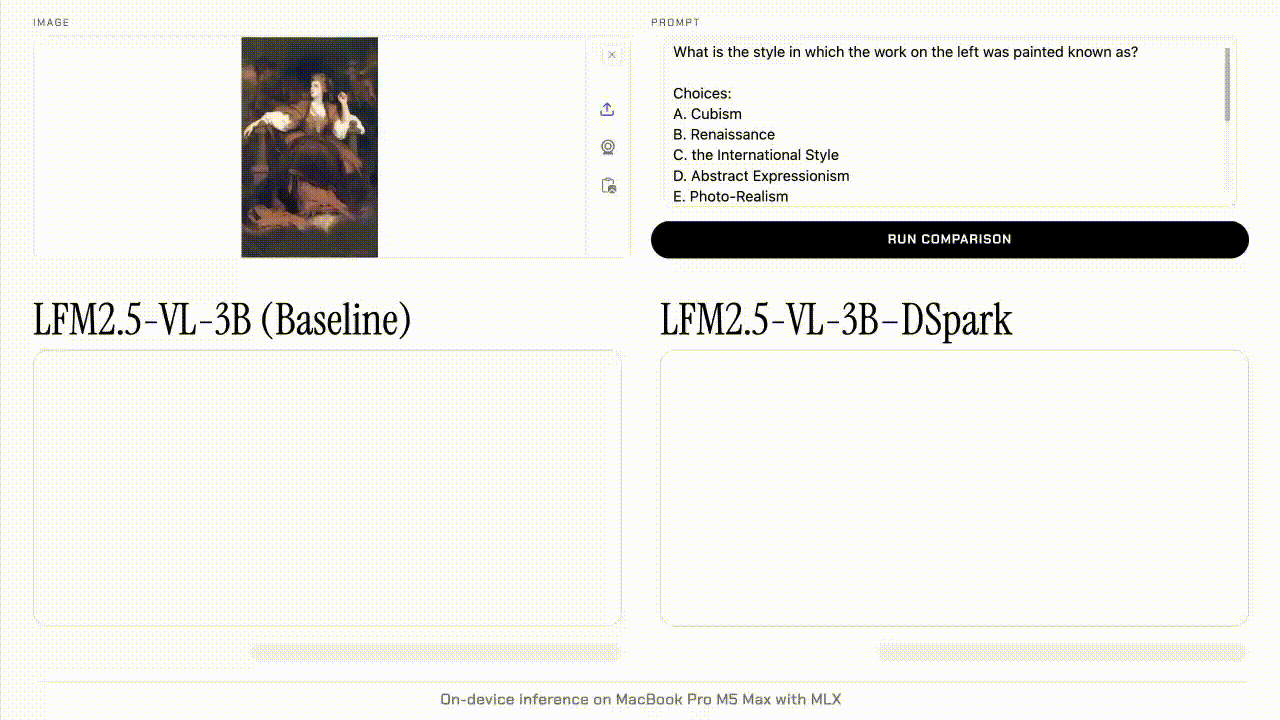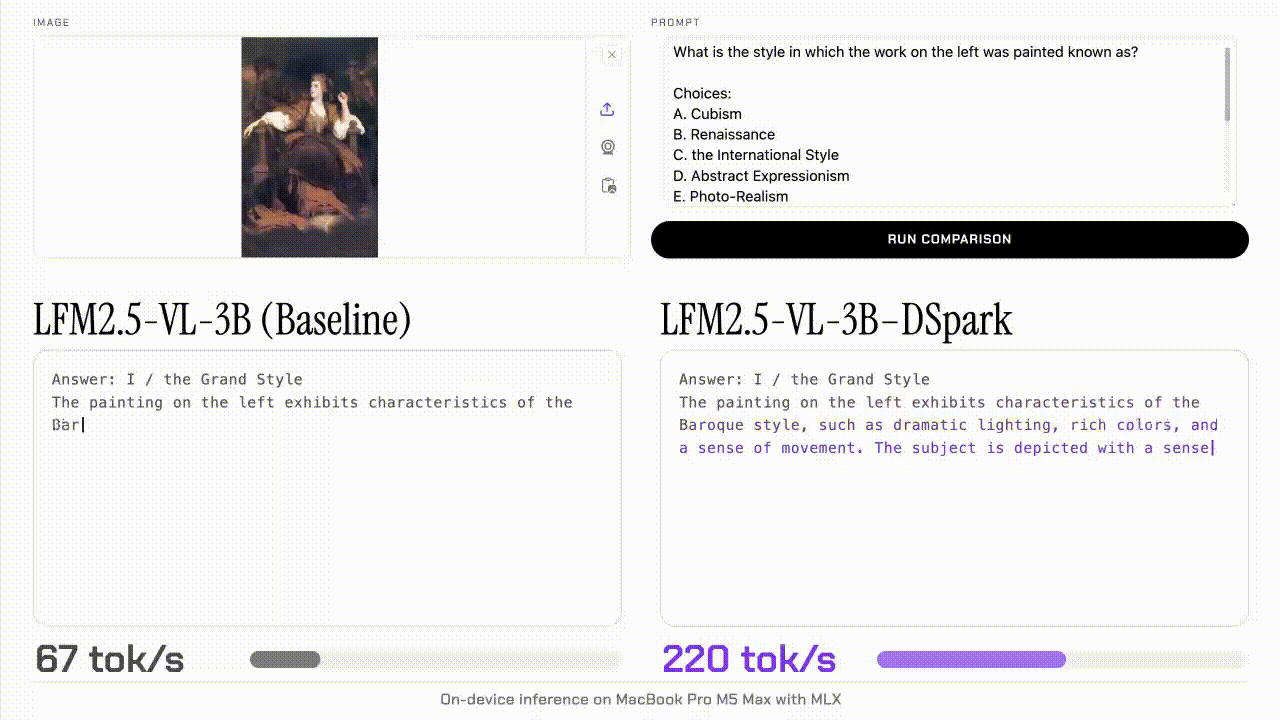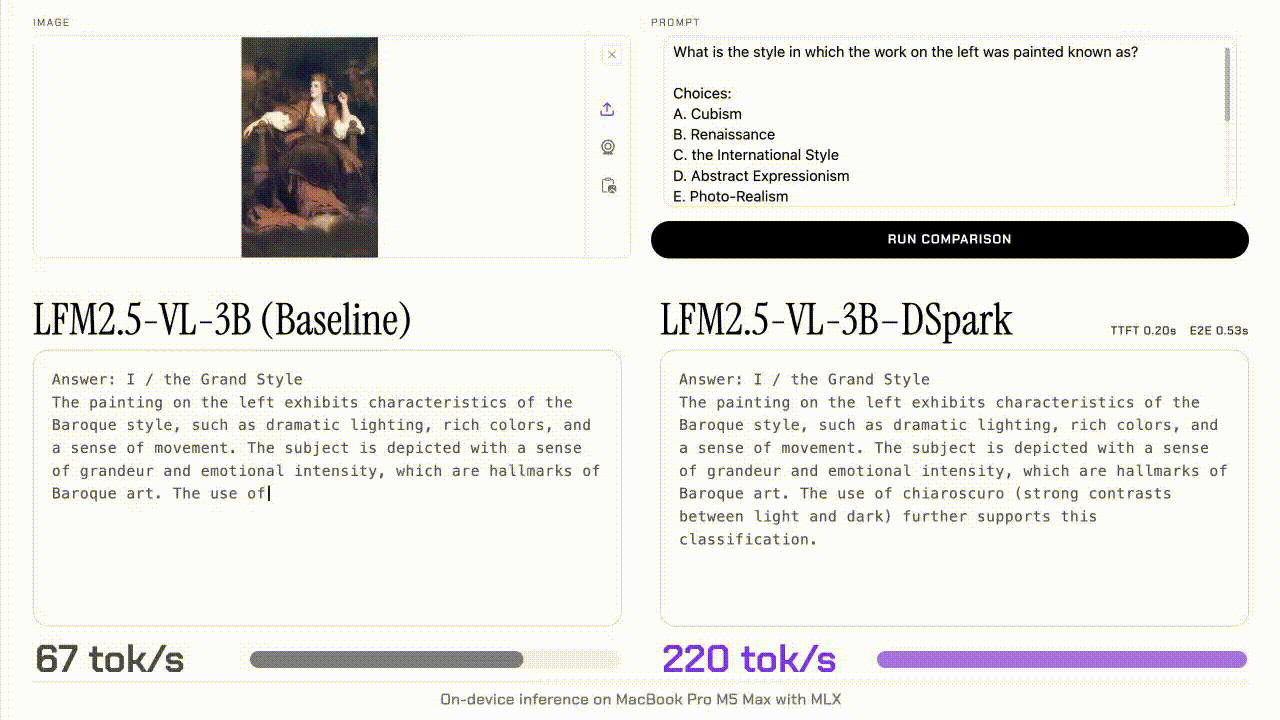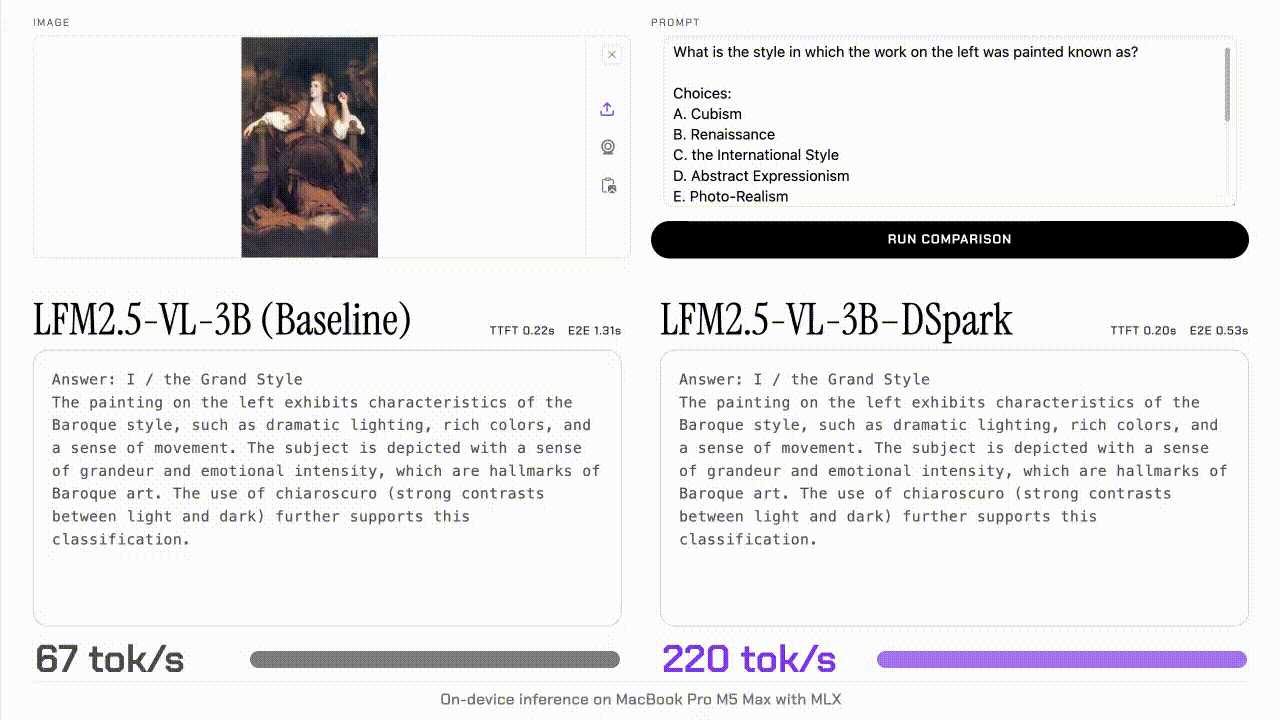
Liquid AI vừa ra mắt mô hình thử nghiệm LFM2.5-VL-DSpark nhằm tăng tốc độ xử lý cho mô hình thị giác ngôn ngữ (VLM) LFM2.5-VL-3B. Kỹ thuật này áp dụng phương pháp speculative decoding, chấp nhận tăng nhẹ dung lượng bộ nhớ để đạt được tốc độ sinh dữ liệu nhanh hơn mà không làm thay đổi chất lượng đầu ra.
Mô hình dự đoán (drafter) này có kích thước khoảng 280M tham số, chỉ làm tăng 8,9% tổng số lượng tham số của mô hình deployed. Drafter sử dụng kiến trúc chú ý (attention-only) gồm 4 lớp với block size gợi ý từ 8 đến 9. Công cụ hỗ trợ sẵn ngay từ đầu cho các nền tảng phổ biến như llama.cpp, MLX-VLM và SGLang.
Kết quả thử nghiệm cho thấy hiệu năng ấn tượng trên nhiều phần cứng. Khi chạy với MLX trên chip M5 Max, tốc độ decode tăng từ 2,30x đến 3,13x, giúp độ trễ end-to-end cải thiện 1,56x đến 2,62x. Trên GPU NVIDIA H100, tốc độ decode tăng từ 2,04x đến 2,66x và end-to-end cải thiện tới 2,27x trên các tác vụ như VQA, mô tả hình ảnh và suy luận phức tạp.
Đối với cộng đồng nghiên cứu và phát triển AI tại Việt Nam, phương pháp này mở ra giải pháp tối ưu hóa chi phí tính toán và giảm độ trễ khi triển khai các mô hình đa phương thức VLM trên cả thiết bị edge lẫn hạ tầng GPU.
Nguồn: Hugging Face — Biên dịch & tổng hợp: danhbaai.com