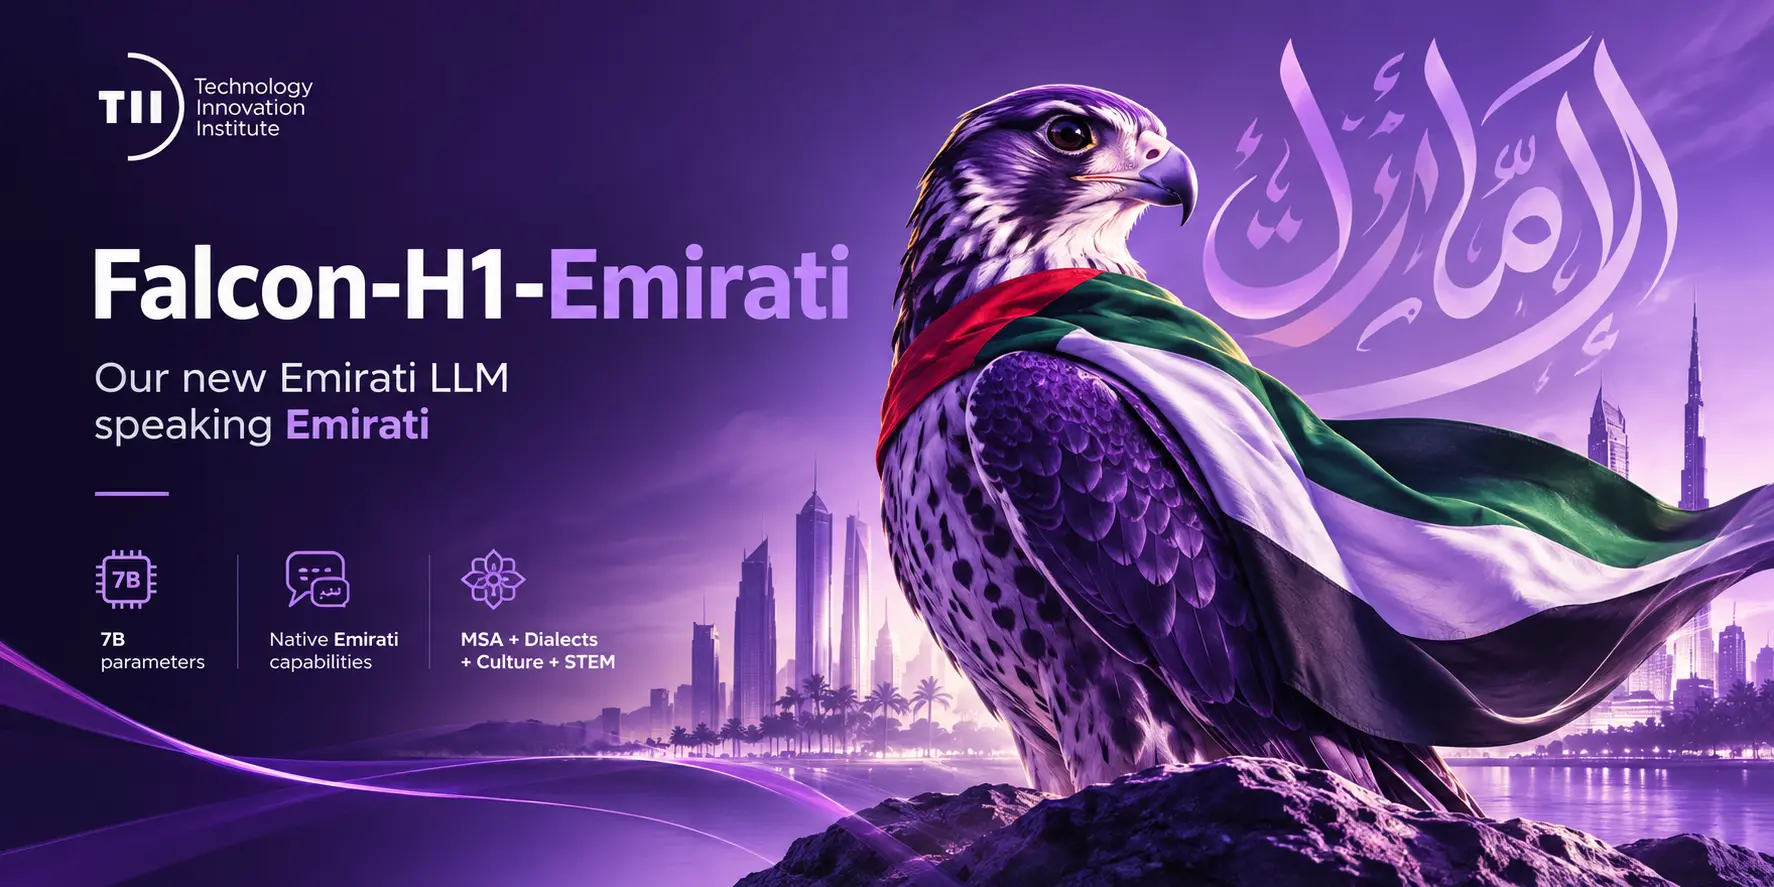
Hugging Face và đội ngũ phát triển vừa giới thiệu Falcon-Emirati-7B, mô hình LLM chuyên biệt dành riêng cho phương ngữ Ả Rập UAE (Emirati Arabic). Khác với tiếng Ả Rập chuẩn (MSA) thường xuất hiện trên báo chí, tiếng Ả Rập bản địa UAE sở hữu từ vựng, nhịp điệu và ngữ cảnh văn hóa độc đáo như thơ nabati hay tục ngữ. Việc ra mắt phiên bản này giúp giải quyết rào cản ngữ nghĩa mà các model Ả Rập tổng quát trước đây thường bỏ lỡ.
Falcon-Emirati-7B được phát triển dựa trên nền tảng Falcon-H1-Arabic, sử dụng kiến trúc lai (hybrid) kết hợp giữa State Space Models (Mamba) và Transformer attention chạy song song trong mỗi block. Sự kết hợp này mang lại hiệu suất thời gian tuyến tính của Mamba trên các chuỗi văn bản dài, đồng thời duy trì độ chính xác của cơ chế attention đối với các phụ thuộc xa. Đội ngũ nghiên cứu quyết định chọn quy mô 7B tham số vì đây là điểm cân bằng lý tưởng giữa khả năng tiếp thu sắc thái ngôn ngữ phức tạp và chi phí huấn luyện cũng như inference thực tế.
Hệ hình mô hình này thừa hưởng khả năng xử lý cửa sổ ngữ cảnh lên tới 128K và 256K token từ dòng Falcon-H1, đồng thời được luyện trên đường ống dữ liệu (pipeline) thu thập tự nhiên từ các trang web và diễn đàn bản địa tại UAE. Nhờ đó, model không chỉ hiểu nghĩa đen mà còn nắm bắt chính xác phong cách giao tiếp, thương thảo và kể chuyện thực tế của người dân địa phương.
Xu hướng phát triển các LLM tối ưu cho từng phương ngữ như Falcon-Emirati-7B mang lại gợi ý quan trọng cho cộng đồng AI Việt Nam. Việc tinh chỉnh model theo chiều sâu văn hóa và ngôn ngữ bản địa sẽ giúp nâng cao trải nghiệm người dùng cuối, tạo ra các ứng dụng AI tự nhiên và gần gũi hơn với đời sống.
Nguồn: Hugging Face — Biên dịch & tổng hợp: danhbaai.com