
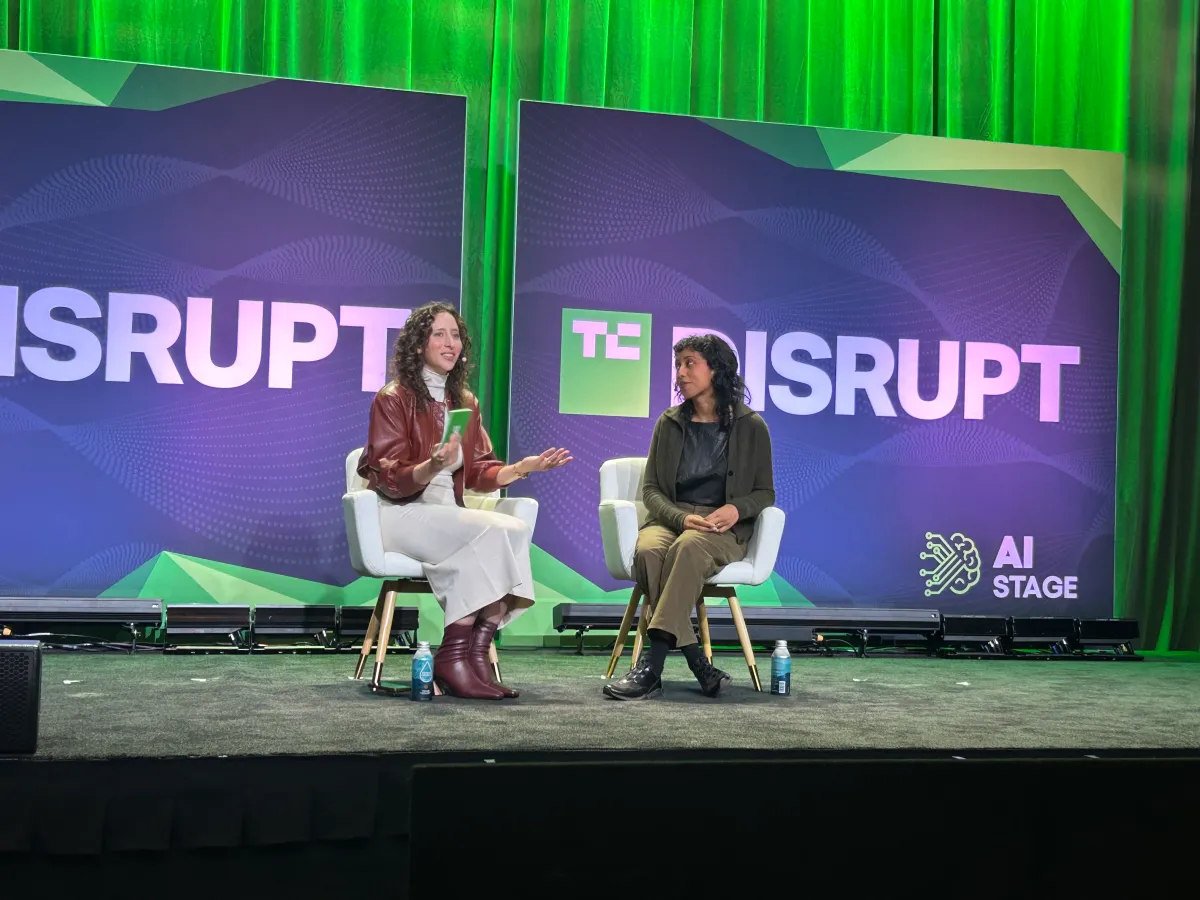
Hugging Face cảnh báo rằng việc triển khai các evaluator AI nhúng không phải là giải pháp nhanh chóng để giải quyết vấn đề đánh giá mô hình. Irene Solaiman, Giám đốc Chính sách của công ty, nhấn mạnh rằng benchmark hiện nay còn thiếu tiêu chuẩn đồng nhất và khả năng tái tạo kết quả.
Solaiman chỉ ra rằng, để tin tưởng vào một đánh giá, người dùng cần có quyền truy cập vào trọng số mở (open weights) và có thể tái hiện lại quy trình thử nghiệm. Hiện tại, nhiều benchmark chỉ đo lường hiệu năng mô hình mà không xét đến phần “harness” – công cụ và môi trường truy cập mô hình – khiến kết quả có thể bị sai lệch.
Trong buổi thảo luận tại TechCrunch Disrupt, cô cũng đề cập đến việc các evaluator nhúng – các bên thứ ba trung lập được đặt trong nội bộ các phòng lab AI – đang trở nên phổ biến. Tuy nhiên, tiêu chuẩn để xác định ai là evaluator hiệu quả vẫn chưa rõ ràng, và các công ty như Anthropic đã gặp phản ứng tiêu cực khi thuê Accenture làm evaluator.
Solaiman kết luận rằng, đánh giá toàn diện cần mở rộng từ mô hình sang hệ thống xung quanh, bao gồm harness và agent. Để benchmark trở thành công cụ đáng tin cậy, ngành cần một khung chuẩn công nghiệp chung, giúp mọi bên cùng một trang và giảm thiểu rủi ro khi so sánh các kết quả.
Nguồn: TechCrunch — Biên dịch & tổng hợp: danhbaai.com