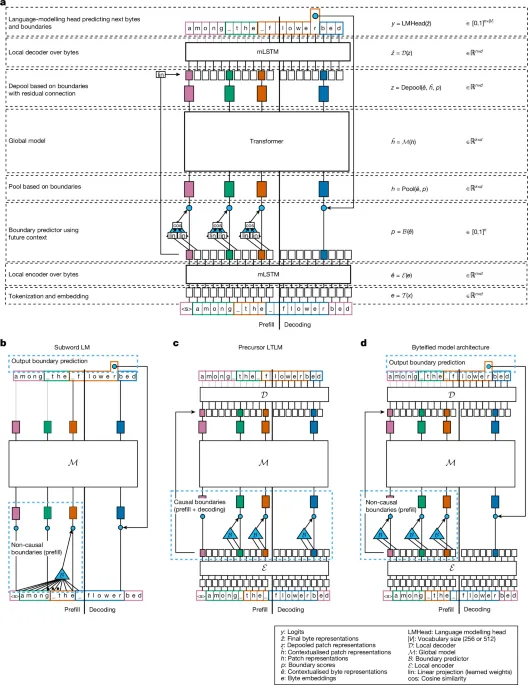
Một nghiên cứu mới công bố trên tạp chí Nature đã giới thiệu phương pháp “byteification” cho phép chuyển đổi các LLM dựa trên subword hiện có thành các mô hình hoạt động ở cấp độ byte (byte-level) với chi phí huấn luyện bổ sung tối thiểu. Phương pháp này giải quyết triệt để rào cản hiệu năng tồn tại lâu nay giữa các mô hình xử lý byte và các mô hình dựa trên subword tokenization truyền thống.
Hầu hết các LLM hiện nay chia nhỏ văn bản thành các đơn vị subword, khiến mô hình gặp hạn chế khi xử lý các dữ liệu đòi hỏi độ chính xác cao đến từng ký tự như mã máy tính (code) hoặc chuỗi sinh học. Bằng kỹ thuật chuyển đổi hai giai đoạn, phương pháp mới giúp model tiếp nhận trực tiếp mã hóa byte UTF-8 của văn bản thô. Kết quả thử nghiệm cho thấy mô hình mới vượt trội ở các tác vụ lập luận cấp độ ký tự, đồng thời duy trì tốc độ suy luận (inference) thực tế và tái sử dụng được hệ sinh thái sẵn có của mô hình gốc.
Phương pháp này cũng giúp giảm bớt sự thiên vị ngôn ngữ (English-centricity) do việc chia subword gây ra, tạo điều kiện cho mô hình tối ưu hóa chi phí tính toán trên các dạng dữ liệu phức tạp.
Đây là bước tiến quan trọng mang lại nhiều giá trị cho cộng đồng nghiên cứu AI tại Việt Nam, đặc biệt trong các bài toán xử lý mã nguồn, dữ liệu y sinh hoặc phát triển các công cụ xử lý tiếng Việt vốn chịu nhiều hạn chế bởi các bộ tách từ subword hiện tại.
Nguồn: Hacker News — Biên dịch & tổng hợp: danhbaai.com