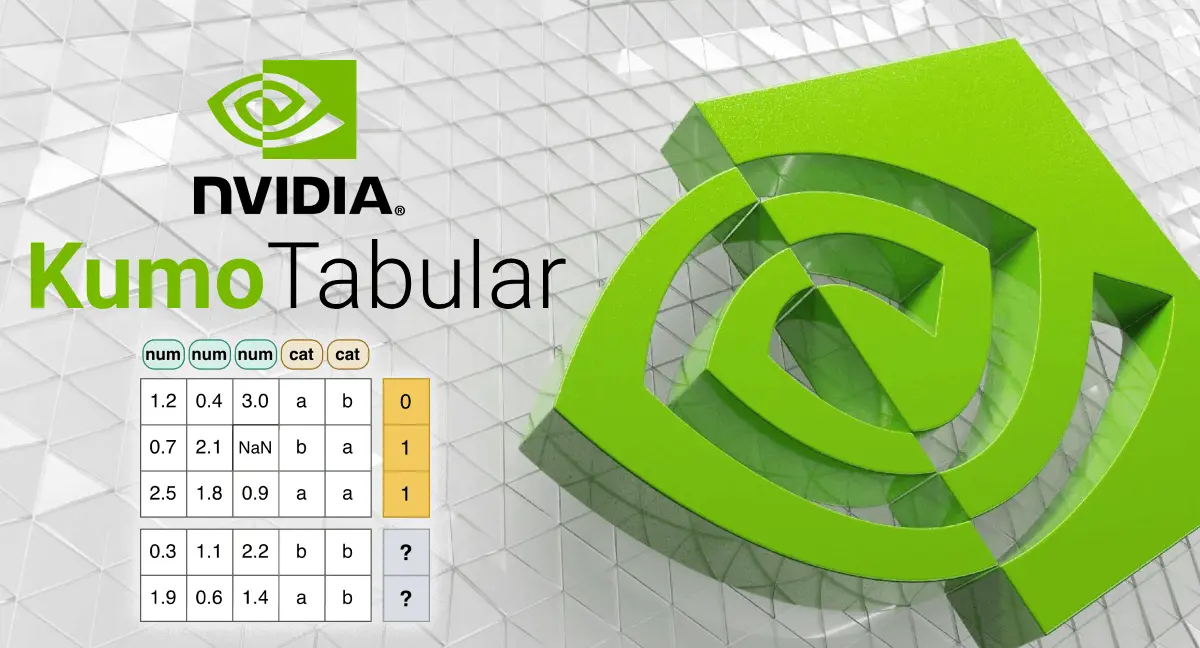
NVIDIA vừa phát hành Kumo Tabular, một foundation model mã nguồn mở chuyên dự đoán dữ liệu dạng bảng (tabular data), hiện đã có mặt trên Hugging Face. Điểm đặc biệt: model thực hiện cả classification lẫn regression chỉ trong một forward pass duy nhất, không cần training, fine-tuning hay feature engineering.
Kumo Tabular có ba phiên bản từ 28M đến 215M tham số, được pretrain hoàn toàn trên dữ liệu nhân tạo và phát hành dưới giấy phép OpenMDW-1.1 cho phép sử dụng thương mại. Model đã xếp hạng nhất trên cả bốn benchmark quan trọng: TabArena, BeyondArena, TALENT và ScoringBench — thiết lập chuẩn mới về cả độ chính xác lẫn hiệu suất cho bài toán tabular prediction.
Về kiến trúc, Kumo Tabular là một Transformer được thiết kế riêng cho cấu trúc bảng, kế thừa ý tưởng từ TabICL và TabPFN. Model hoạt động qua ba giai đoạn chính:
- Cell Embedding: Nhóm các ô thành token, giá trị số và phân loại đi qua Fourier features; giá trị thiếu được xử lý đặc biệt mà không cần imputation.
- Row Embedding: Kết hợp column attention (học ý nghĩa giá trị trong phân phối cột) và row attention (học tương tác giữa các feature), chi phí tính toán tăng tuyến tính theo số hàng.
- In-context Learning: Transformer cuối cùng cho phép query rows tham chiếu đến context rows có nhãn để đưa ra dự đoán, tương tự cách LLM học từ few-shot examples.
Kumo Tabular đánh dấu bước tiến quan trọng khi đưa paradigm in-context learning vào lĩnh vực dữ liệu bảng — vốn thống trị bởi gradient-boosted trees suốt hai thập kỷ. Với cộng đồng AI Việt Nam, đây là công cụ mã nguồn mở hữu ích cho các bài toán dự đoán churn, fraud, demand trong doanh nghiệp mà không cần pipeline ML phức tạp.
Nguồn: Hugging Face — Biên dịch & tổng hợp: danhbaai.com