
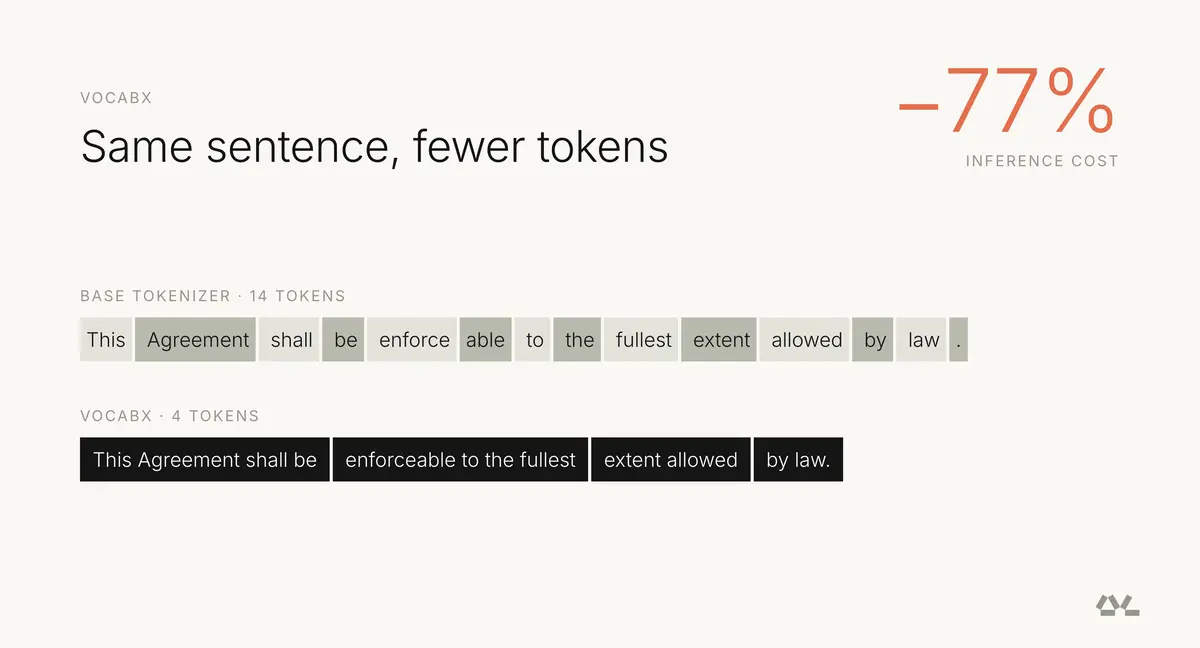
VocabX là kỹ thuật mới giúp tối ưu hoá tokenizer của các mô hình ngôn ngữ (SLM) khi chúng được chuyên môn hoá cho một miền hoặc nhiệm vụ cụ thể. Trong một hệ thống chấm bài luận tiếng Bồ Đào Nha đang chạy thực tế, nhóm đã áp dụng VocabX lên mô hình Qwen3‑4B (4 tỷ tham số) và giảm chi phí suy luận tới 77%.
Hai vấn đề chính của tokenizer chung khiến chi phí tăng cao là:
- Fragmentation: tokenizer chia các đoạn văn bản lặp lại trong miền thành nhiều token, khiến mỗi phản hồi tiêu tốn nhiều token hơn cần thiết.
- Excess: từ vựng chứa hàng chục nghìn mục mà miền không bao giờ dùng, nhưng mô hình vẫn phải tính xác suất cho tất cả các mục này ở mỗi bước sinh token.
Với VocabX, nhóm giữ nguyên mô hình gốc, dữ liệu và quy trình fine‑tuning, chỉ thay đổi tokenizer. Kích thước từ vựng giảm từ 151.669 xuống còn mức tối thiểu cho tiếng Bồ Đào Nha và định dạng JSON đầu ra, đồng thời không làm giảm chất lượng chấm điểm. Kết quả đo lường cho thấy thời gian suy luận giảm đáng kể và chi phí GPU giảm mạnh.
Thành tựu này cho thấy tokenizer không chỉ là một thành phần tĩnh mà còn là “cần cẩu” chi phí quan trọng khi triển khai mô hình trong thực tế. Các nhà phát triển AI Việt Nam có thể áp dụng VocabX cho các mô hình chuyên môn hoá như chấm bài, dịch thuật hay trợ lý ảo, hứa hẹn giảm chi phí vận hành và mở rộng quy mô dịch vụ.
Với việc giảm 77% chi phí suy luận mà không thay đổi mô hình gốc, VocabX mở ra hướng đi mới cho việc tối ưu hoá AI mở nguồn, đặc biệt hữu ích cho cộng đồng AI Việt Nam đang tìm kiếm giải pháp tiết kiệm tài nguyên.
Nguồn: Hugging Face — Biên dịch & tổng hợp: danhbaai.com