
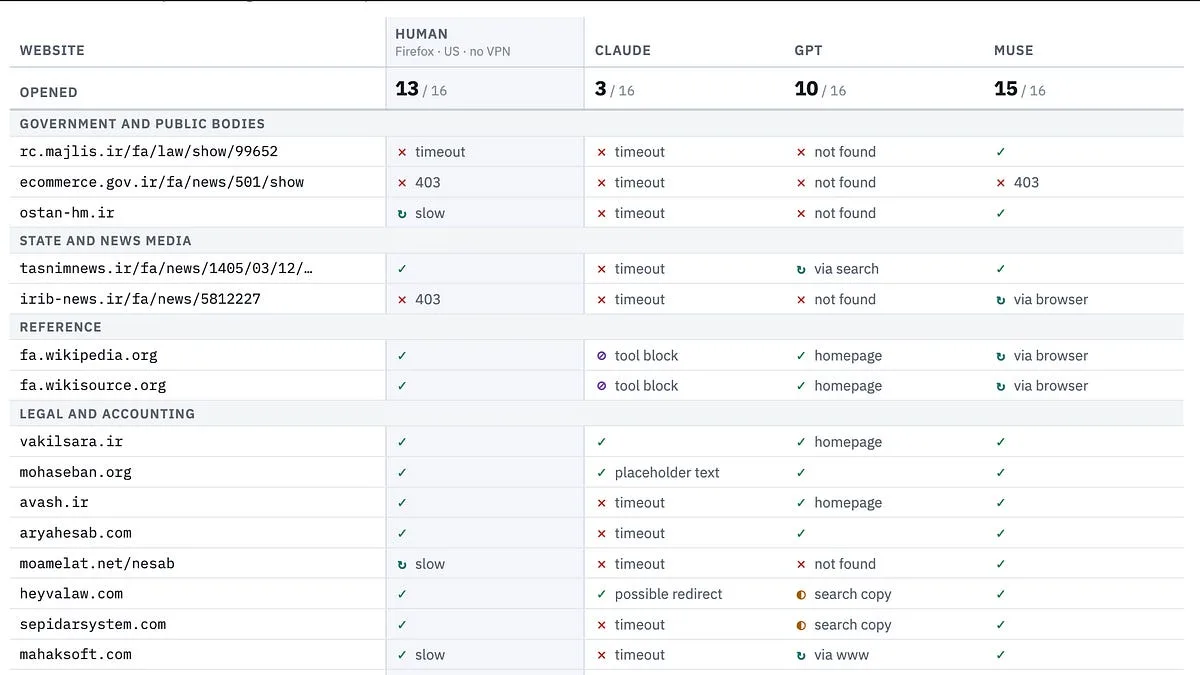
Nhà nghiên cứu nhân quyền và công nghệ Roya Pakzad vừa công bố thử nghiệm thực tế nhằm đánh giá cách các agent AI gồm GPT, Claude và Muse thực hiện nhiệm vụ thu thập dữ liệu đa ngôn ngữ tại Mỹ và Iran. Nghiên cứu tập trung vào trải nghiệm người dùng thực tế trên bản web, phân tích cách các agent xử lý quyền truy cập thông tin, rào cản ngôn ngữ và cơ chế kiểm duyệt có sự tham gia của con người (human-in-the-loop – HITL).
Trong bài thử nghiệm bổ sung thông tin cho Ngân hàng Thế giới, các agent phải thu thập dữ liệu bằng tiếng Anh cho Mỹ và tiếng Farsi cho Iran. Kết quả cho thấy sự khác biệt rõ rệt trong cơ chế xin cấp quyền của người dùng:
- GPT: Chỉ yêu cầu cấp phép một lần duy nhất ở đầu quy trình với tùy chọn cho phép tất cả các trang web liên quan.
- Claude: Liên tục xin phép ở từng bước với 9 lần yêu cầu cho tác vụ tại Mỹ và 9 lần cho tác vụ tại Iran, hoàn toàn không có tùy chọn chấp thuận toàn bộ.
Bên cạnh đó, các rào cản kỹ thuật và môi trường thực thi (sandbox) cũng ảnh hưởng lớn đến khả năng làm việc của agent. Claude gặp hạn chế khi không thể tải dữ liệu trực tiếp từ cổng thông tin Ngân hàng Thế giới do trang web sử dụng JavaScript và chính sách bảo mật mạng trong môi trường sandbox đã ngăn chặn tệp dữ liệu. Agent sau đó phải tạm dừng và yêu cầu người dùng tự tải tệp PDF lên hoặc tiếp tục công việc mà không có dữ liệu đó.
Thử nghiệm này mang lại bài học giá trị cho cộng đồng phát triển và ứng dụng AI tại Việt Nam trong việc thiết kế hệ thống agent. Việc cân bằng giữa tính tiện lợi, khả năng tự chủ của agent và sự kiểm soát từ con người là yếu tố then chốt để xây dựng các giải pháp AI an toàn, tin cậy.
Nguồn: Hacker News — Biên dịch & tổng hợp: danhbaai.com