
Tại sao fine-tuning lâu hơn dự đoán FLOPs? Hugging Face giải thích qua 272 lần chạy thực tế
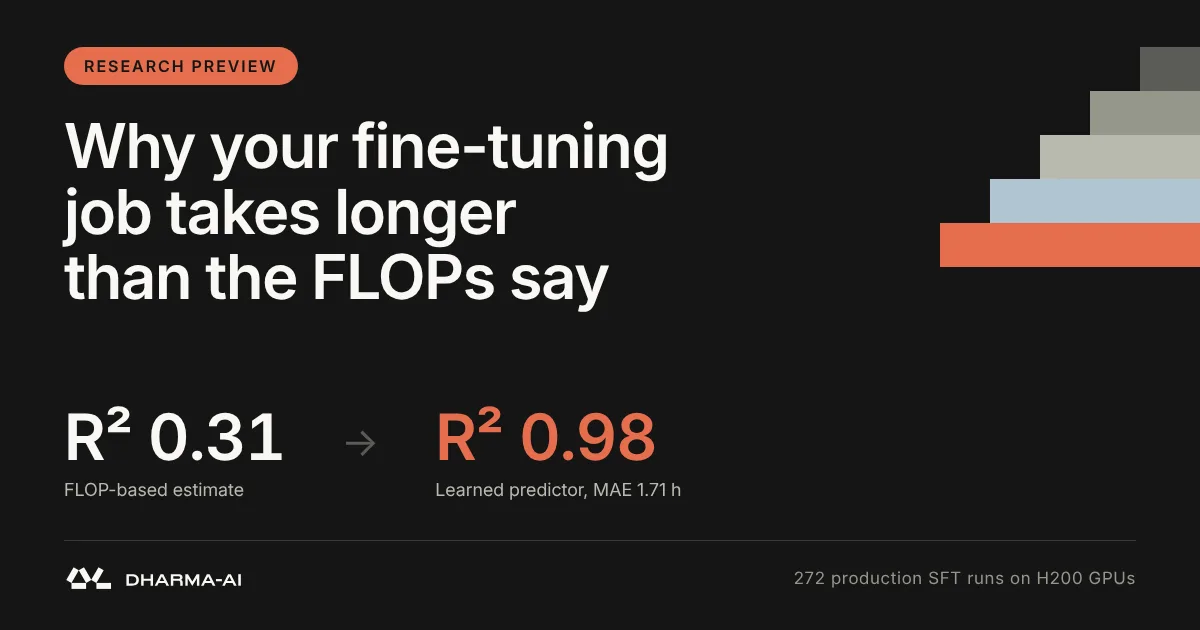
Hugging Face công bố kết quả nghiên cứu “Predicting End-to-End Fine-Tuning Time for Generative Language Models” dựa trên 272 job supervised fine-tuning (SFT) thực tế trên cụm GPU H200, tổng cộng 7.382 GPU-giờ. Kết quả cho thấy ước lượng FLOPs truyền thống (back-of-the-envelope) sai lệch lớn: R² chỉ 0,31, sai số trung bình tuyệt đối (MAE) 12,41 giờ.
Nguyên nhân chính: công thức FLOPs chỉ tính vòng lặp huấn luyện (6·P·D / N_GPU·FLOPS_peak·MFU) nhưng bỏ qua các chi phí overhead phi tuyến tính — setup môi trường, tải model/tokenizer, evaluation định kỳ, checkpoint upload, lưu model cuối cùng vào object storage. Trên cụm đa tenant, mọi thứ cạnh tranh I/O mạng và lưu trữ, khiến hai job cùng FLOPs có thể chênh lệch nhiều giờ.
Giải pháp: Xử lý như bài toán hồi quy có giám sát. Mô hình CatBoost chỉ dùng thông tin có trước khi dispatch (cấu hình job, metadata model, evaluation cadence, checkpoint policy, per-GPU load, fine-tuning regime) đạt R²=0,98, MAE 1,71 giờ, median error 0,51 giờ (5-fold CV). Mô hình học được tương tác phi tuyến giữa các tín hiệu mà công thức đóng không nắm bắt được.
Đối với các team AI Việt Nam vận hành GPU cluster (cloud hoặc on-premise), bài học rõ ràng: đừng tin ước lượng FLOPs đơn giản để lập lịch. Việc xây dựng predictor từ lịch sử chạy thực tế giúp tối ưu hóa sử dụng GPU, giảm idle time và dự án trễ hạn — yếu tố sống còn khi GPU H100/H200 khan hiếm và đắt đỏ.
Bài được AI biên dịch và tóm tắt từ nguồn trên. Xem bài gốc để có đầy đủ thông tin.