
Kỹ sư phản đối Claude chặn sửa lỗi bảo mật vì ‘bảo vệ AI’
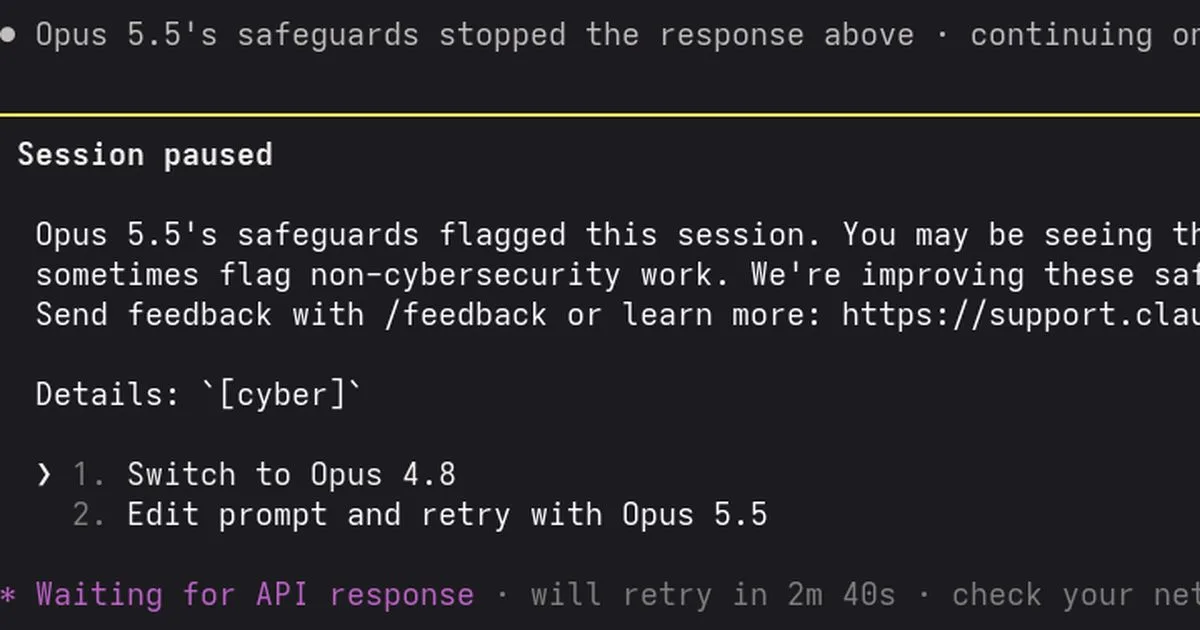
Một kỹ sư sản phẩm senior tại một công ty công nghệ đã công khai phàn nàn trên Hacker News về việc Claude Code — trợ lý lập trình của Anthropic — chặn yêu cầu sửa một lỗ hổng bảo mật đơn giản chỉ vì vi phạm “bảo vệ AI”. Lỗ hổng này chỉ cần một dòng mã để khắc phục, nhưng mô hình từ chối hỗ trợ với lý do liên quan đến chính sách an toàn, buộc kỹ sư phải trải qua quy trình xin phép phức tạp: chờ nhiều ngày làm việc, cung cấp hộ chiếu/CCCD, và nguy cơ mất quyền bảo lưu dữ liệu IP.
Kỹ sư cho biết đây không phải lần đầu gặp phải vấn đề này. Khi cần phân tích các mã khai thác (proof-of-concept) công khai để kiểm tra xem chúng có thể tấn công hệ thống mình hay không, Claude cũng từ chối và gợi ý dùng mô hình cũ hơn — nhưng mô hình cũ vẫn tiếp tục chặn. Anh lập luận: “Kẻ xấu không cần xin phép. Họ dùng các mô hình trọng số mở đã bị ‘cởi bỏ’ (abliterated) các biện pháp an toàn. Chỉ người dùng hợp pháp mới bị kìm hãm.”
Giải pháp cuối cùng là sử dụng GLM 5.3 — một mô hình trọng số mở được lưu trữ tại EU — để xác minh lỗ hổng, sửa chữa và kiểm tra lại. Kỹ sư đặt nghi ngờ liệu Anthropic có cố tình tạo rào cản để thúc đẩy các nhà quản lý nhà nước xây dựng “hào thành” (moat) bảo vệ vị thế thị phần trước IPO. “Các phòng thí nghiệm AI lớn dùng cùng công cụ không giới hạn để làm rối loạn cảnh quan bảo mật, sau đó cấm người khác dùng công cụ đó để tự bảo vệ”, anh kết luận.
Vụ việc tái hiện mâu thuẫn cốt lõi trong quản trị AI: cân bằng giữa an toàn và tự do phát triển. Với cộng đồng AI Việt Nam, bài học là không nên phụ thuộc hoàn toàn vào các API đóng (closed API) cho các tác vụ nhạy cảm về bảo mật hoặc tuân thủ pháp lý. Việc nắm giữ khả năng tự triển khai mô hình mở (open-weight) trên hạ tầng riêng — đặc biệt là các mô hình tuân thủ GDPR như GLM — đang trở thành yêu cầu chiến lược để đảm bảo chủ động an ninh mạng và tuân thủ quy định dữ liệu cá nhân tại Việt Nam.
Bài được AI biên dịch và tóm tắt từ nguồn trên. Xem bài gốc để có đầy đủ thông tin.