
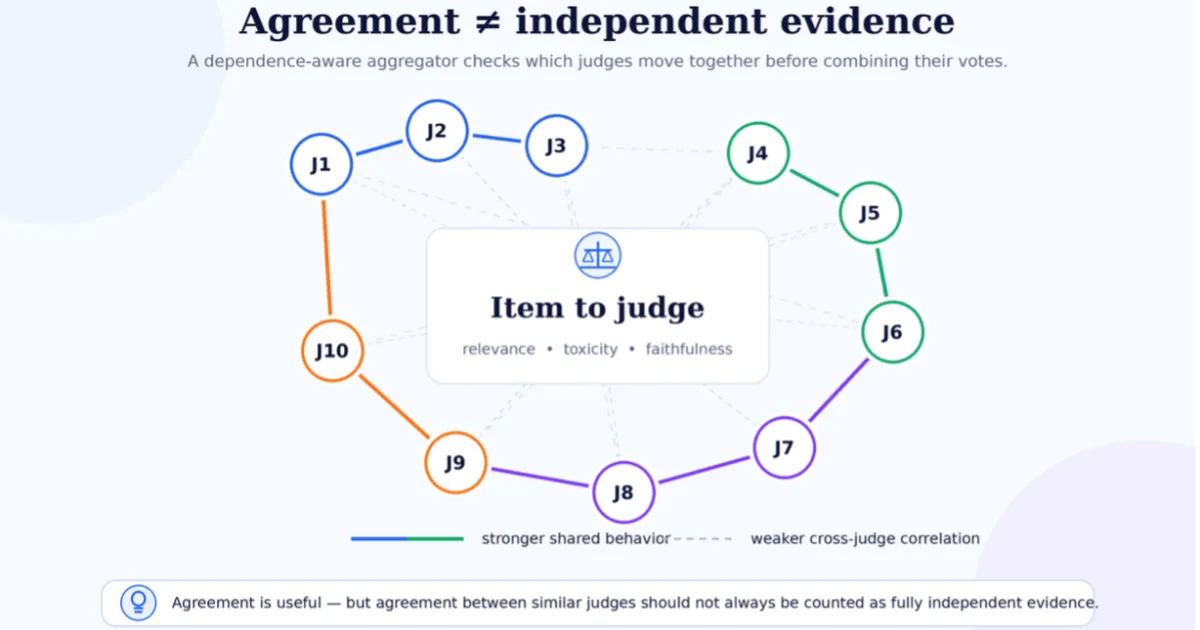
Trong bối cảnh các hệ thống trí tuệ nhân tạo ngày càng phát triển, việc sử dụng các mô hình ngôn ngữ lớn (LLM) làm giám khảo để đánh giá chất lượng đầu ra của các LLM khác đang trở nên phổ biến. Tuy nhiên, một câu hỏi lớn được đặt ra trong cộng đồng nghiên cứu là liệu chúng ta có thực sự nên tin tưởng tuyệt đối khi các mô hình này đưa ra những phán quyết đồng thuận hay không.
Các nghiên cứu gần đây trong lĩnh vực suy luận tự động và học máy cho thấy rằng mặc dù các LLM có thể xử lý lượng dữ liệu khổng lồ, chúng vẫn mang những điểm mù hệ thống hoặc thiên vị tiềm ẩn giống nhau. Khi nhiều mô hình cùng đưa ra một nhận định, sự đồng thuận đó đôi khi chỉ phản ánh các mẫu dữ liệu huấn luyện tương tự thay vì một đánh giá khách quan thực sự.
Đối với cộng đồng AI và các nhà phát triển tại Việt Nam, việc hiểu rõ giới hạn của LLM trong vai trò giám khảo là cực kỳ quan trọng. Khi ứng dụng AI vào các bài toán tự động hóa hoặc kiểm định chất lượng phần mềm, các kỹ sư cần kết hợp thêm nhiều phương pháp kiểm chứng độc lập thay vì chỉ dựa vào kết quả đồng thuận của một nhóm mô hình.
Nguồn: Hacker News — Biên dịch & tổng hợp: danhbaai.com