
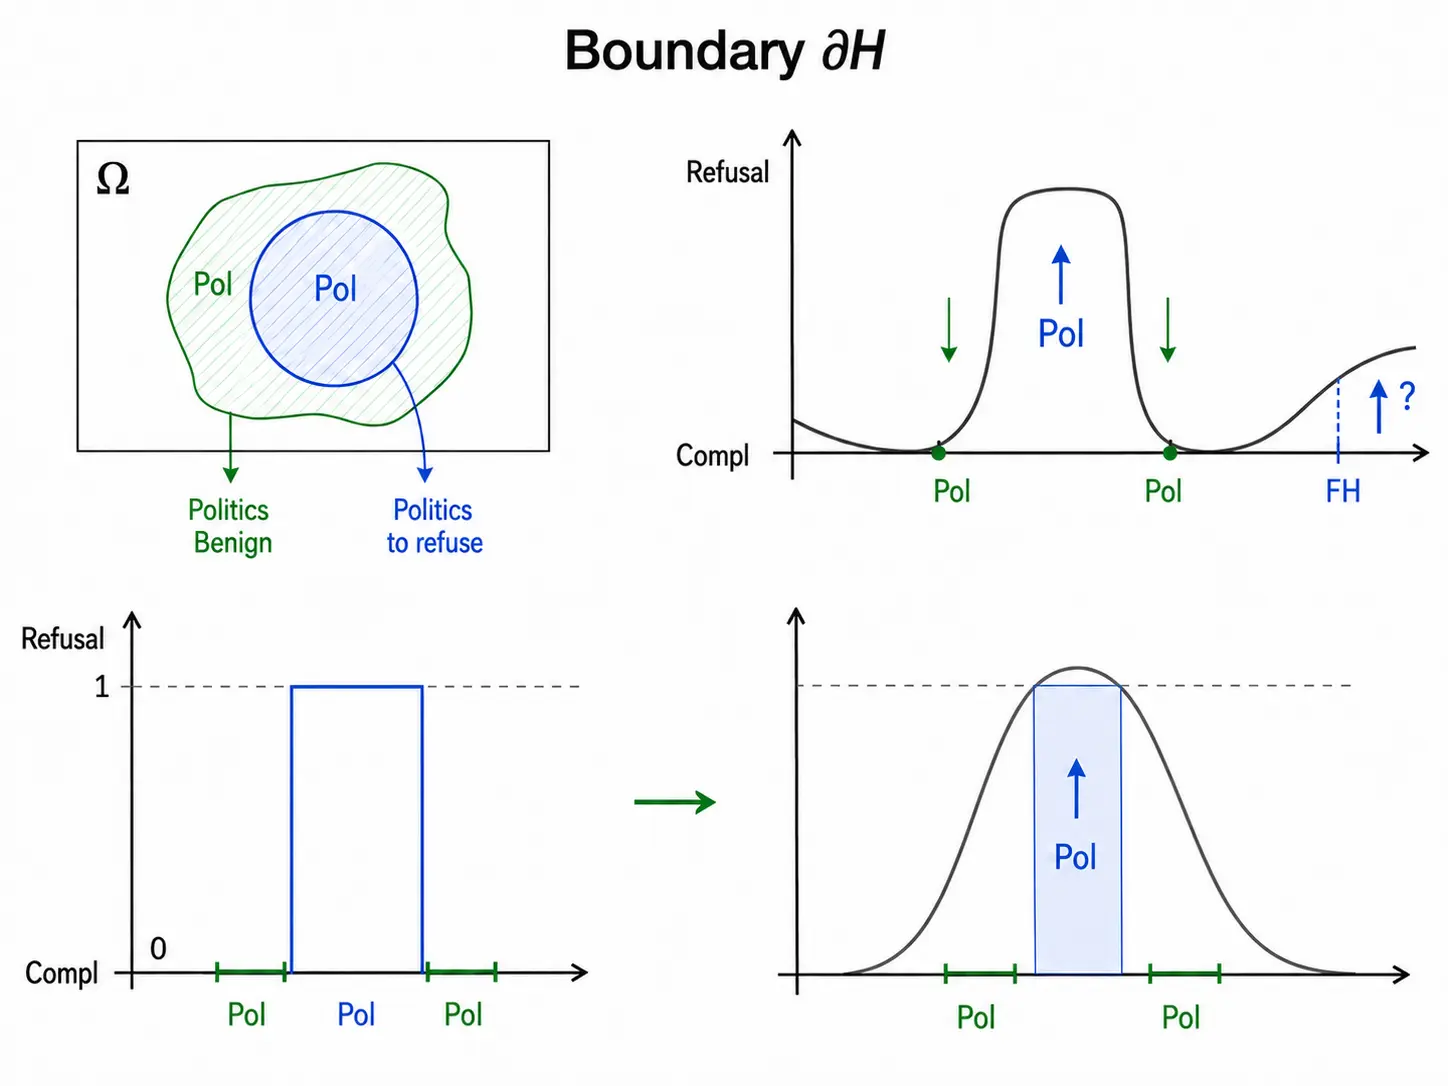
Nhóm nghiên cứu tại Hugging Face vừa công bố bài báo khoa học “Safety for Whom? Boundary-Aware Self-Distillation for Controlled LLM Safety Refusal”, đề xuất phương pháp mới để tinh chỉnh cơ chế an toàn cho các mô hình ngôn ngữ lớn (LLM). Thay vì chặn toàn bộ một chủ đề rộng như chính trị hay y tế, nghiên cứu tập trung vào việc xác định ranh giới hẹp để AI chỉ từ chối các yêu cầu có nguy cơ gây hại.
Hiện nay, các công cụ kiểm duyệt như LlamaGuard-3 thường phân loại an toàn theo chủ đề chung, dẫn đến tình trạng mô hình từ chối cả những câu hỏi hoàn toàn lành tính nếu chứa từ khóa nhạy cảm. Phương pháp “Self-Distillation nhận biết ranh giới” của Hugging Face sử dụng các cặp prompt chung chủ đề nhưng khác biệt về ý định (ví dụ: truy vấn thông tin bầu cử hợp lệ đối lập với yêu cầu tạo nội dung thao túng cử tri) để huấn luyện mô hình đưa ra phản hồi chính xác hơn tại khu vực ranh giới.
Nghiên cứu này mang ý nghĩa quan trọng đối với các nhà phát triển AI tại Việt Nam khi triển khai LLM trong các lĩnh vực như giáo dục hay dịch vụ công. Việc kiểm duyệt thông minh theo ranh giới sẽ giúp ứng dụng AI hoạt động hữu ích, trả lời đúng trọng tâm các thắc mắc của người dùng mà không bị hiện tượng từ chối nhầm các câu hỏi hợp lệ.
Nguồn: Hugging Face — Biên dịch & tổng hợp: danhbaai.com