
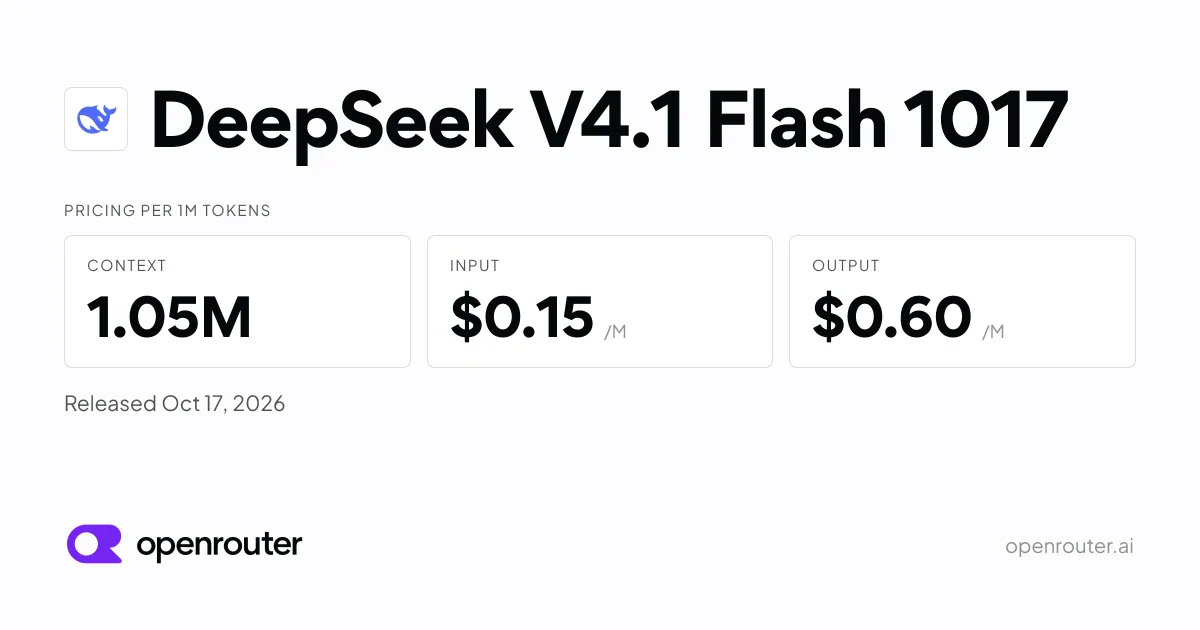
DeepSeek V4.1 Flash 1017 là bản snapshot ngày 17/10/2026 của mô hình DeepSeek V4.1 Flash, được cung cấp dưới tên API deepseek-flash. Đây là mô hình sparse mixture‑of‑experts đầu tiên dựa trên kiến trúc Causal Encoder‑Decoder (CED) của DeepSeek, với tổng 552 tỷ tham số, trong đó chỉ kích hoạt 8 tỷ tham số khi nhận đầu vào và 16 tỷ khi sinh đầu ra, giúp giảm tính toán trên mỗi token.
Kiến trúc này còn hỗ trợ hiểu hình ảnh một cách nguyên bản: các embedding hình ảnh và văn bản được huấn luyện đồng thời từ đầu, không phải thêm vào sau như các phiên bản thử nghiệm trước (V4 Flash Vision Exp). Nhờ vậy, mô hình thích hợp cho các agent làm việc trong môi trường terminal, lập trình, và các tác vụ dài hạn cần phân tích ngữ cảnh rộng.
DeepSeek nhấn mạnh lợi thế về chi phí và tốc độ. Cơ chế cache KV nén giảm bộ nhớ cache xuống còn khoảng một phần tư so với thế hệ Flash trước, giảm đáng kể chi phí cho các workload agentic. Theo OpenRouter, mô hình này vượt trội hơn DeepSeek V4 Pro về hiệu năng, tốc độ và thời gian hoàn thành nhiệm vụ, đồng thời duy trì tốc độ throughput lên tới 141 token/giây và latency thấp.
OpenRouter cung cấp đa nhà cung cấp, tự động chuyển hướng khi có lỗi, và tính toán giá thực tế (thường thấp hơn mức niêm yết). Người dùng chỉ cần thay đổi URL cơ sở trong SDK tương thích OpenAI để gọi mô hình, thuận tiện cho việc tích hợp vào các ứng dụng AI.
Với khả năng xử lý đa mô hình (ngôn ngữ + hình ảnh) và chi phí hợp lý, DeepSeek V4.1 Flash 1017 hứa hẹn mở ra cơ hội cho cộng đồng phát triển AI Việt Nam triển khai các agent thông minh, công cụ lập trình tự động và các dự án AI đa phương tiện mà không phải lo lắng về chi phí hạ tầng.
Nguồn: Hacker News — Biên dịch & tổng hợp: danhbaai.com