
Một nghiên cứu mới đánh giá 10 bộ phát hiện tấn công prompt injection mã nguồn mở trên tập dữ liệu 629 cuộc tấn công AI agent thực tế (AgentDojo) đã chỉ ra điểm yếu chết người của các giải pháp bảo mật hiện tại. Kết quả cho thấy không có công cụ nào có thể ngăn chặn hiệu quả các cuộc tấn công ẩn trong kết quả trả về của công cụ (tool output) mà không vô tình chặn luôn cả các truy vấn hợp lệ.
Cụ thể, mô hình Prompt Guard 2 của Meta chỉ phát hiện được vỏn vẹn 1% số cuộc tấn công thực tế. Công cụ của ProtectAI đạt tỷ lệ chặn 100% khi đứng một mình, nhưng khi nằm trong đoạn email hay hóa đơn thông thường thì tỷ lệ phát hiện giảm xuống còn 23% do nhiễu văn bản xung quanh. Ngược lại, các công cụ như Deepset hay fmops bắt được 100% đe dọa nhưng lại báo động giả tới 98% dữ liệu an toàn. Tỷ lệ cân bằng tốt nhất giữa các công cụ thử nghiệm chỉ đạt 51% phát hiện với 2% báo động sai.
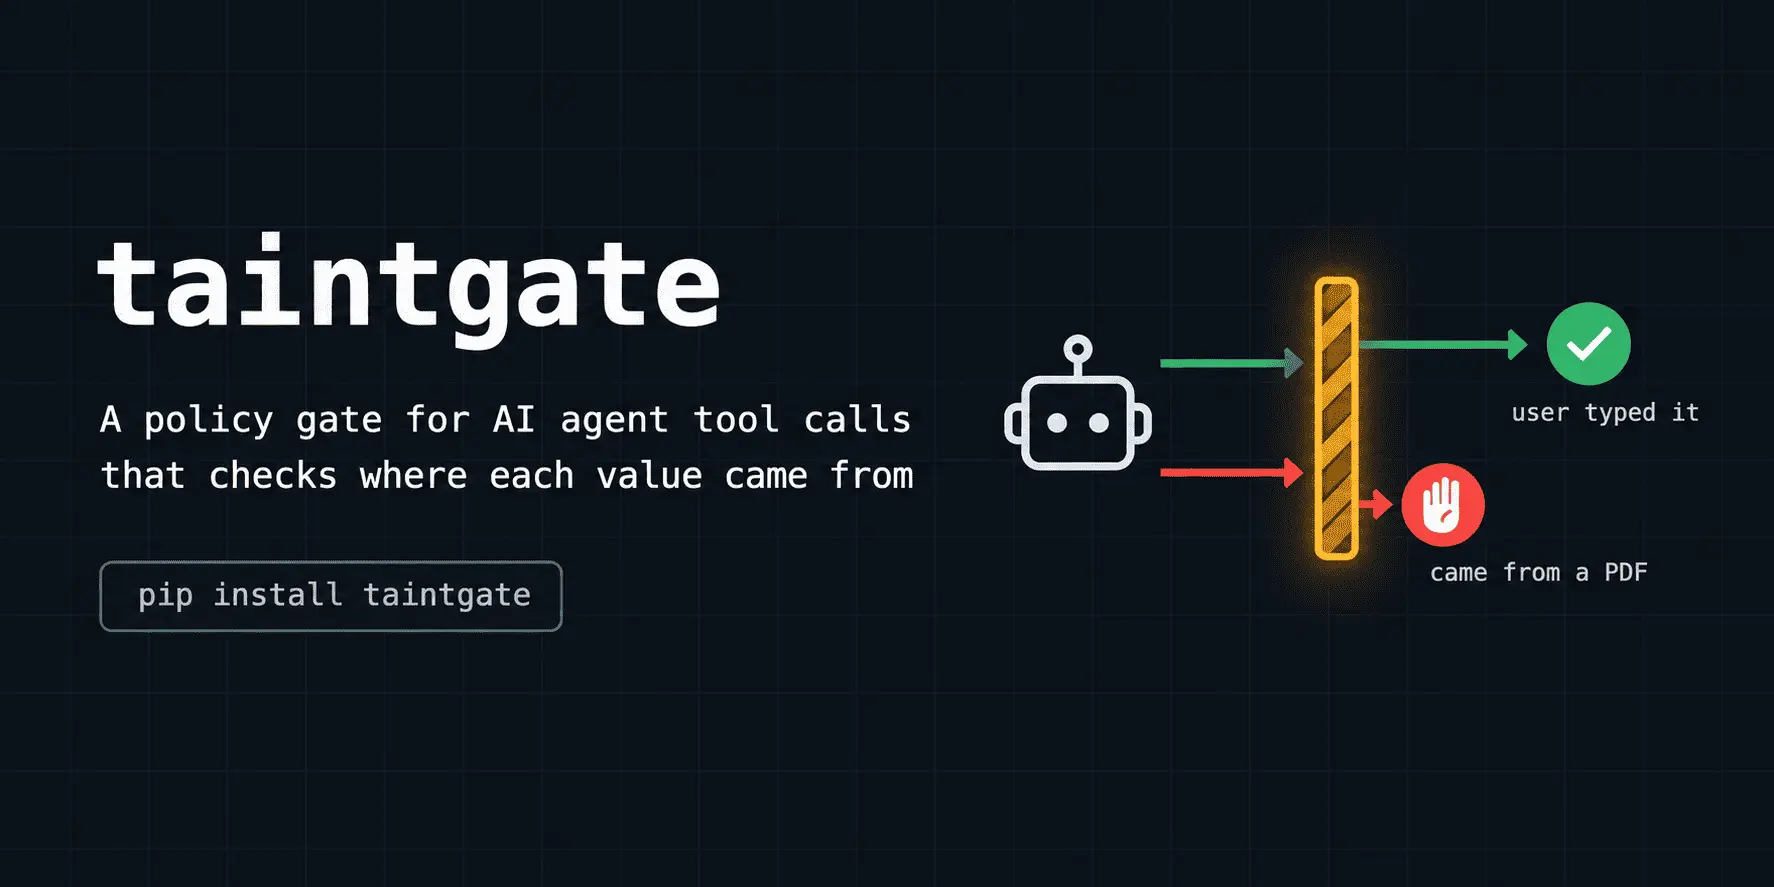
Kết quả nghiên cứu khẳng định rằng việc chỉ quét văn bản thuần túy không thể phân biệt chính xác đâu là lệnh tấn công và đâu là yêu cầu người dùng. Các nhà phát triển AI agent tại Việt Nam cần chuyển dịch sang cơ chế kiểm soát chính sách dựa trên nguồn gốc dữ liệu (như Taintgate) và phân quyền chặt chẽ cho từng công cụ thay vì chỉ phụ thuộc vào các bộ lọc văn bản đơn thuần.
Nguồn: Hacker News — Biên dịch & tổng hợp: danhbaai.com