
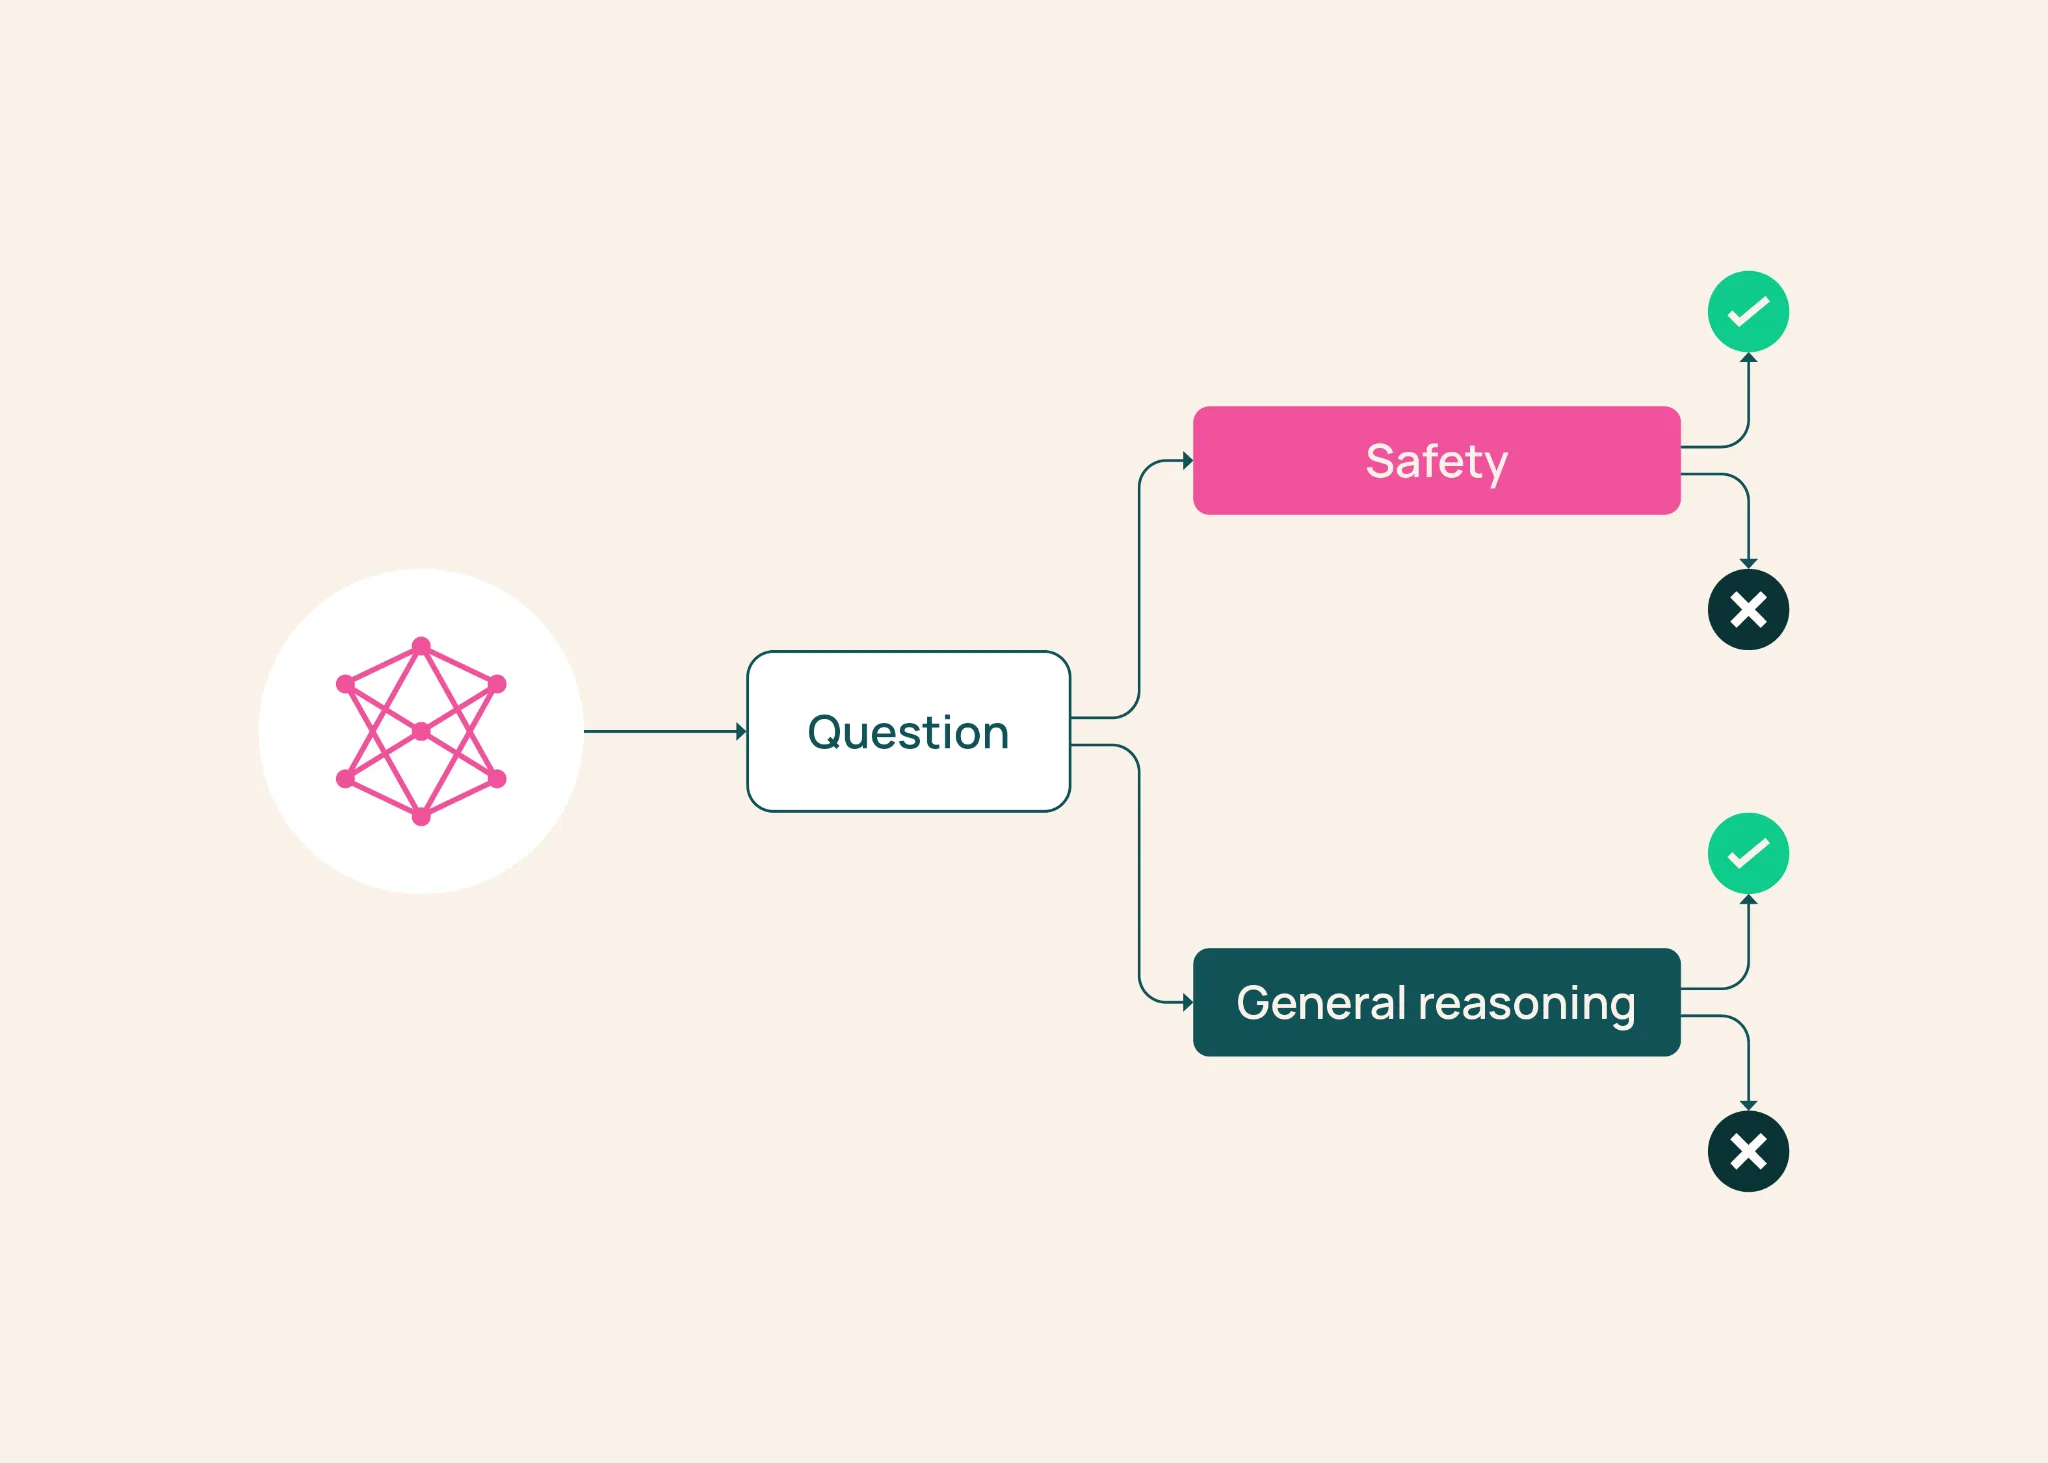
BenchMIRT là một khung đánh giá mới được AllenAI công bố, nhằm tách biệt các tín hiệu thực sự ẩn sau các điểm số benchmark LLM. Thay vì chỉ xem xét điểm tổng, BenchMIRT phân tích hiệu suất của mô hình trên từng prompt và ước lượng mức độ khó và khả năng phân biệt của mỗi câu hỏi.
Phương pháp dựa trên Item Response Theory (IRT) đa chiều, cho phép nhận diện nhiều khả năng (như an toàn và suy luận chung) đồng thời ảnh hưởng đến kết quả. Đội ngũ đã huấn luyện BenchMIRT trên dữ liệu từ 100 LLM, 16 benchmark và hơn 34.000 câu hỏi, bao gồm MMLU‑Pro, GPQA, BBH, cũng như các bộ đánh giá an toàn như HarmBench và WildJailbreak.
- BenchMIRT tự động phát hiện hai chiều chính: an toàn và suy luận chung.
- Khi áp dụng, nó xác nhận rằng các benchmark tập trung vào lý luận thực sự đo lường khả năng suy luận, trong khi các benchmark jailbreak đo lường mức độ an toàn.
Kết quả cho thấy việc gộp các câu hỏi đa dạng vào một điểm số duy nhất có thể che giấu những khác biệt quan trọng, gây hiểu lầm về khả năng thực sự của mô hình.
Nhận định: BenchMIRT cung cấp công cụ mạnh mẽ cho các nhà nghiên cứu và cộng đồng AI Việt Nam để đánh giá chính xác hơn các benchmark, từ đó phát triển các mô hình LLM đáp ứng đúng nhu cầu thực tiễn.
Nguồn: Hugging Face — Biên dịch & tổng hợp: danhbaai.com