
TrnRT: Engine inference LLM mã nguồn mở cho AWS Trainium
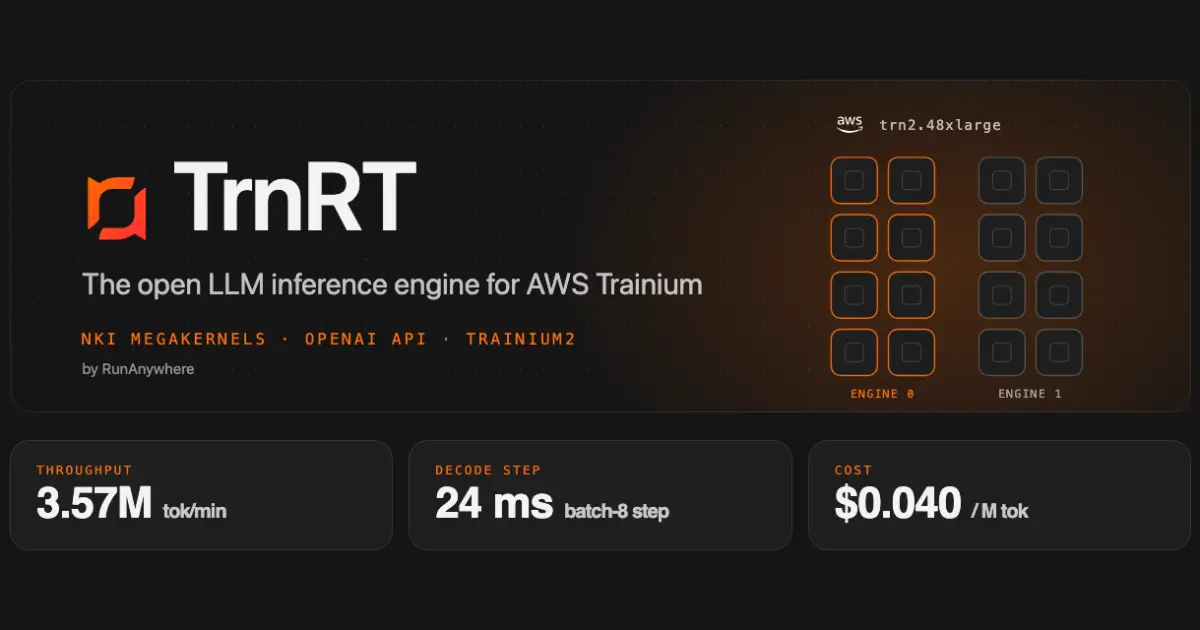
RunanywhereAI công bố TrnRT, một inference engine mã nguồn mở chuyên biệt cho các mô hình ngôn ngữ lớn (LLM) chạy trên chip AWS Trainium2 (instance trn2.48xlarge). Engine này phục vụ API tương thích OpenAI, cho phép developer gọi model như dùng GPT nhưng tận dụng phần cứng Trainium với chi phí thấp hơn GPU NVIDIA.
Điểm kỹ thuật nổi bật: TrnRT triển khai decode dưới dạng NKI megakernel (khoảng một kernel cho mỗi nửa layer), giữ prefix cache liên tục giữa bộ nhớ thiết bị (device) và host. Model đầu tiên được hỗ trợ là GLM-5.3-Flash của Z.ai; các model mở khác đang được tích hợp. Quy trình triển khai bao gồm 3 giai đoạn: build Docker image, compile cache trên host x86_64 (mất vài giờ), và serve trên trn2.48xlarge với volume cache đã biên dịch.
Kết quả benchmark từ SemiAnalysis AgentX cho thấy: trên một trn2.48xlarge giá spot $8,60/giờ (us-east-2), engine chạy context 1M token với 32 agent đồng thời. Chi phí batch 12 chỉ $0,167 triệu token trên capacity block $35,76/giờ. Decode không bị giới hạn băng thông bộ nhớ; bottleneck nằm ở instruction nhỏ, ranh giới kernel và collective operations — được giải quyết bằng thiết kế megakernel giữ working set trong SBUF, dùng đối xứng hai core vật lý, nhúng collectives vào kernel.
Với cộng đồng AI Việt Nam, TrnRT mở ra lựa chọn hạ tầng thay thế NVIDIA GPU với chi phí token cực thấp, phù hợp cho các team muốn tự host LLM quy mô lớn mà không bị khóa vendor. Việc engine mã nguồn mở và hỗ trợ chuẩn OpenAI API giúp dễ dàng tích hợp vào pipeline hiện có.
Bài được AI biên dịch và tóm tắt từ nguồn trên. Xem bài gốc để có đầy đủ thông tin.