
Giải mã cách LLM hiện đại biểu diễn vị trí của token
Trong LLM, mô hình không chỉ cần biết những token nào xuất hiện mà còn phải hiểu vị trí và quan hệ thứ tự giữa chúng. Bài viết “Understanding Positional Embeddings in Modern LLMs” của Sebastian Raschka cung cấp một hướng dẫn chuyên sâu về cách các kiến trúc hiện đại biểu diễn thông tin này, với trọng tâm là positional embeddings và RoPE.
Bài viết bắt đầu từ quy trình cơ bản của một LLM: tokenizer chuyển văn bản thành token ID, lớp input embedding ánh xạ mỗi ID thành một vector, sau đó các transformer block cập nhật những vector này thông qua attention và feedforward layer. Vì attention tự thân không chứa thông tin về thứ tự, mô hình cần một cơ chế bổ sung để phân biệt vị trí của từng token trong chuỗi.
Nội dung lần lượt giải thích các phương pháp kinh điển và đương đại bằng hình minh họa, một phần toán học và triển khai PyTorch quy mô nhỏ. Tác giả đặc biệt dành thời lượng cho relative positional embedding, thường được biết đến qua RoPE, đồng thời so sánh với learned absolute positional embedding từng được dùng trong GPT. Bài viết cũng đề cập cách các kiến trúc mới có thể điều chỉnh hoặc thậm chí loại bỏ positional encoding tường minh.
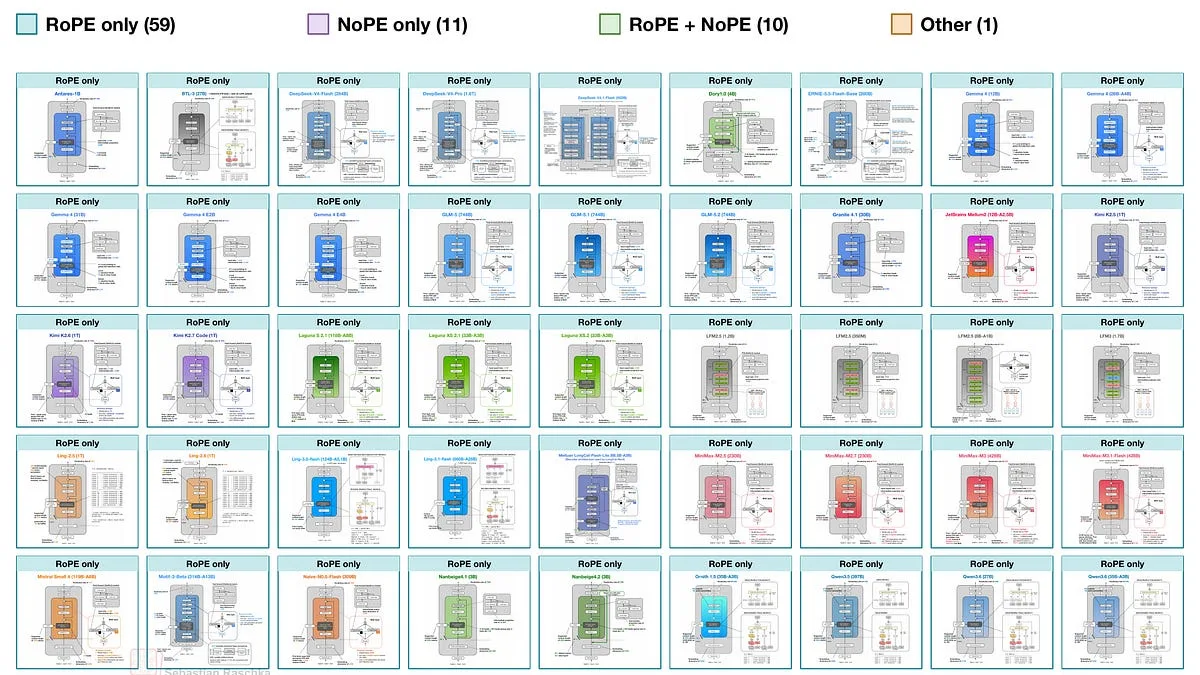
Phần cuối cung cấp cái nhìn tổng quan về lựa chọn positional encoding trong các open-weight model năm 2026, dựa trên gallery kiến trúc của tác giả. Đây là tài liệu nền tảng hữu ích cho người nghiên cứu và phát triển LLM tại Việt Nam muốn hiểu sâu hơn một thành phần thường bị xem nhẹ nhưng ảnh hưởng trực tiếp đến khả năng xử lý ngữ cảnh của model.
Bài được AI biên dịch và tóm tắt từ nguồn trên. Xem bài gốc để có đầy đủ thông tin.