Các model Mixture-of-Experts (MoE) có thể mở rộng lên hàng trăm tỷ parameter, nhưng phải giữ toàn bộ expert MLP trong memory khi inference dù mỗi token chỉ sử dụng một số nhỏ expert. Với ví dụ Qwen3.5-122B, 256 expert xuất hiện ở mỗi trong 48 MoE layer, trong khi chỉ 8 expert được kích hoạt cho một token; phần expert MLP chiếm khoảng 95% trong tổng footprint parameter gần 250 GB.
Expert pruning là cách trực tiếp để giảm memory mà không cần training lại, đồng thời có thể kết hợp với quantization và tránh độ trễ của việc nạp, chuyển expert động. Tuy nhiên, các phương pháp hiện có thường chấm điểm từng expert bằng một scalar importance score rồi xóa expert kém quan trọng độc lập trong từng layer.
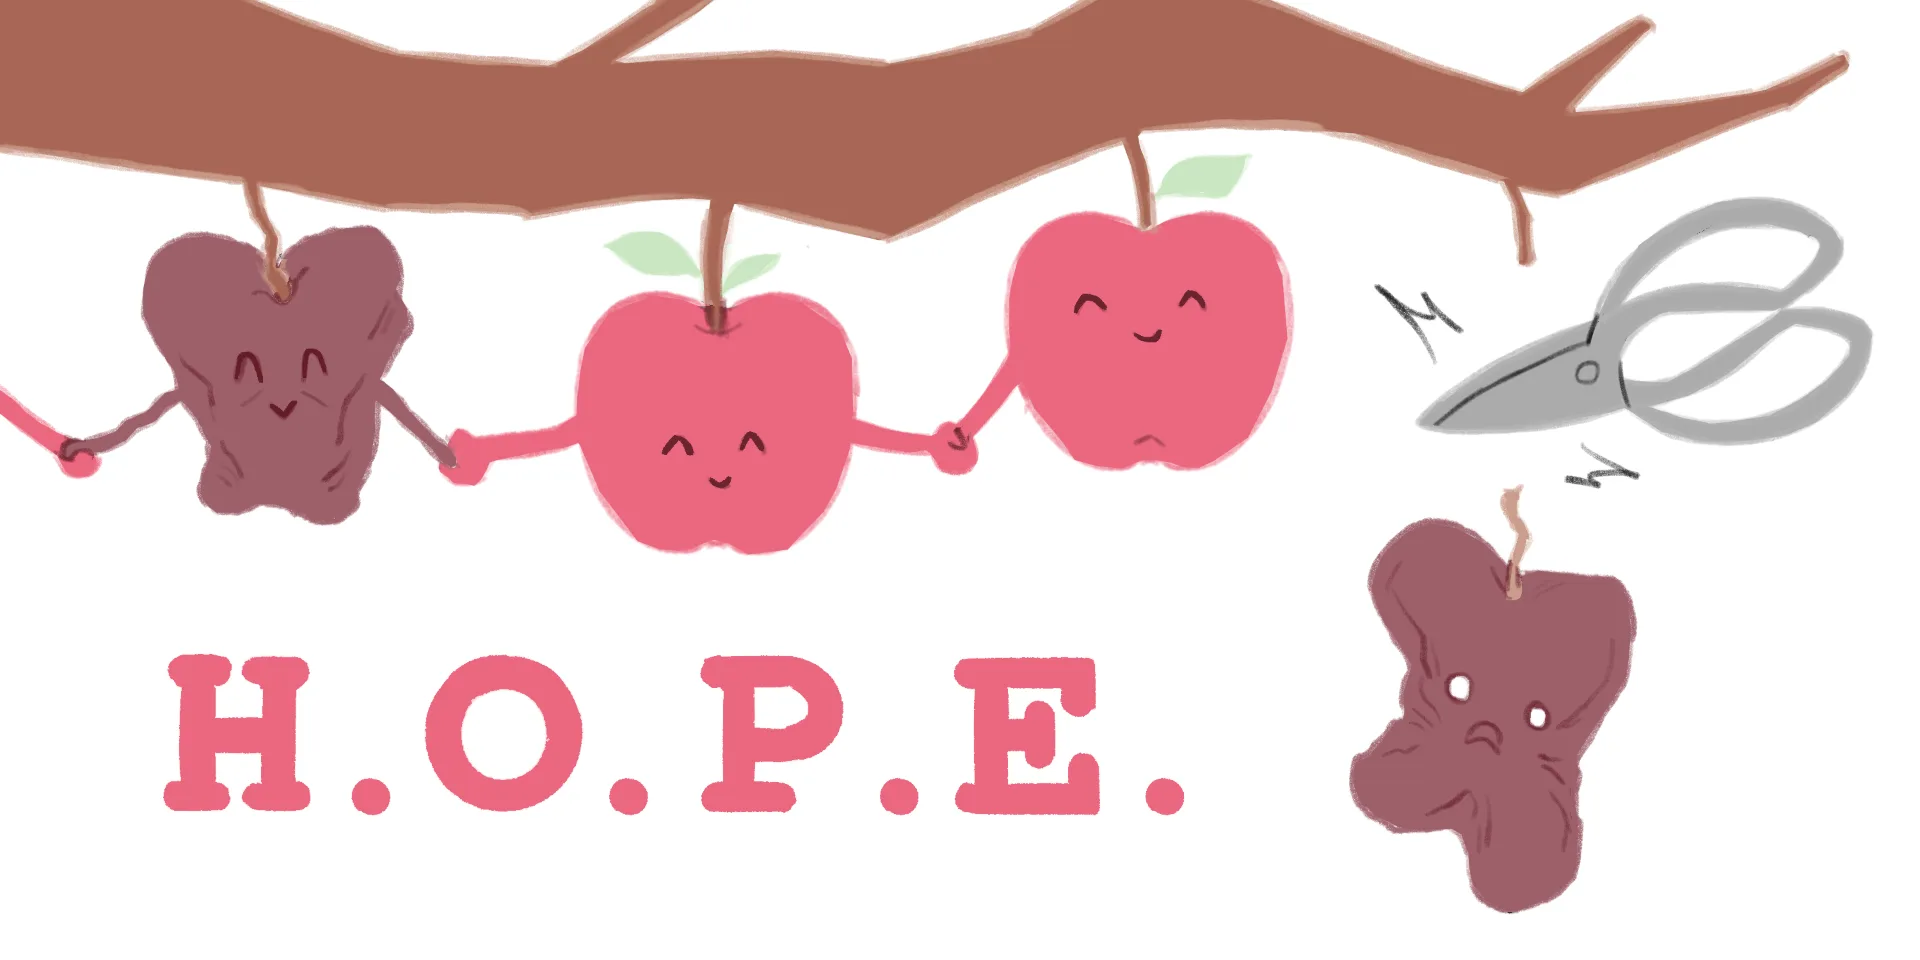
Bài viết giới thiệu HOPE (Higher-Order Pruning of Experts), phương pháp second-order tính đến tương tác theo cặp giữa các expert. Nhóm nghiên cứu nhận thấy các expert thường tạo thành những nhóm được kích hoạt cùng nhau một cách ổn định. Vì vậy, một expert có điểm riêng thấp chưa chắc là lựa chọn an toàn để loại bỏ nếu nó đóng vai trò quan trọng trong một nhóm phối hợp.
Ở mức pruning 50%, HOPE đạt average rank tốt nhất trong các phương pháp được so sánh, với mức tăng tối đa 6,1% trên agentic coding tasks so với phương pháp đứng kế tiếp. Cách tiếp cận này gợi mở hướng nén MoE thực tế hơn, giúp giảm yêu cầu phần cứng cho người dùng và nhóm nghiên cứu tại Việt Nam mà vẫn chú ý đến cấu trúc hợp tác bên trong model.
Nguồn: Hugging Face — Biên dịch & tổng hợp: danhbaai.com