
Dharma Field Extractor biến tài liệu thành JSON theo đúng schema
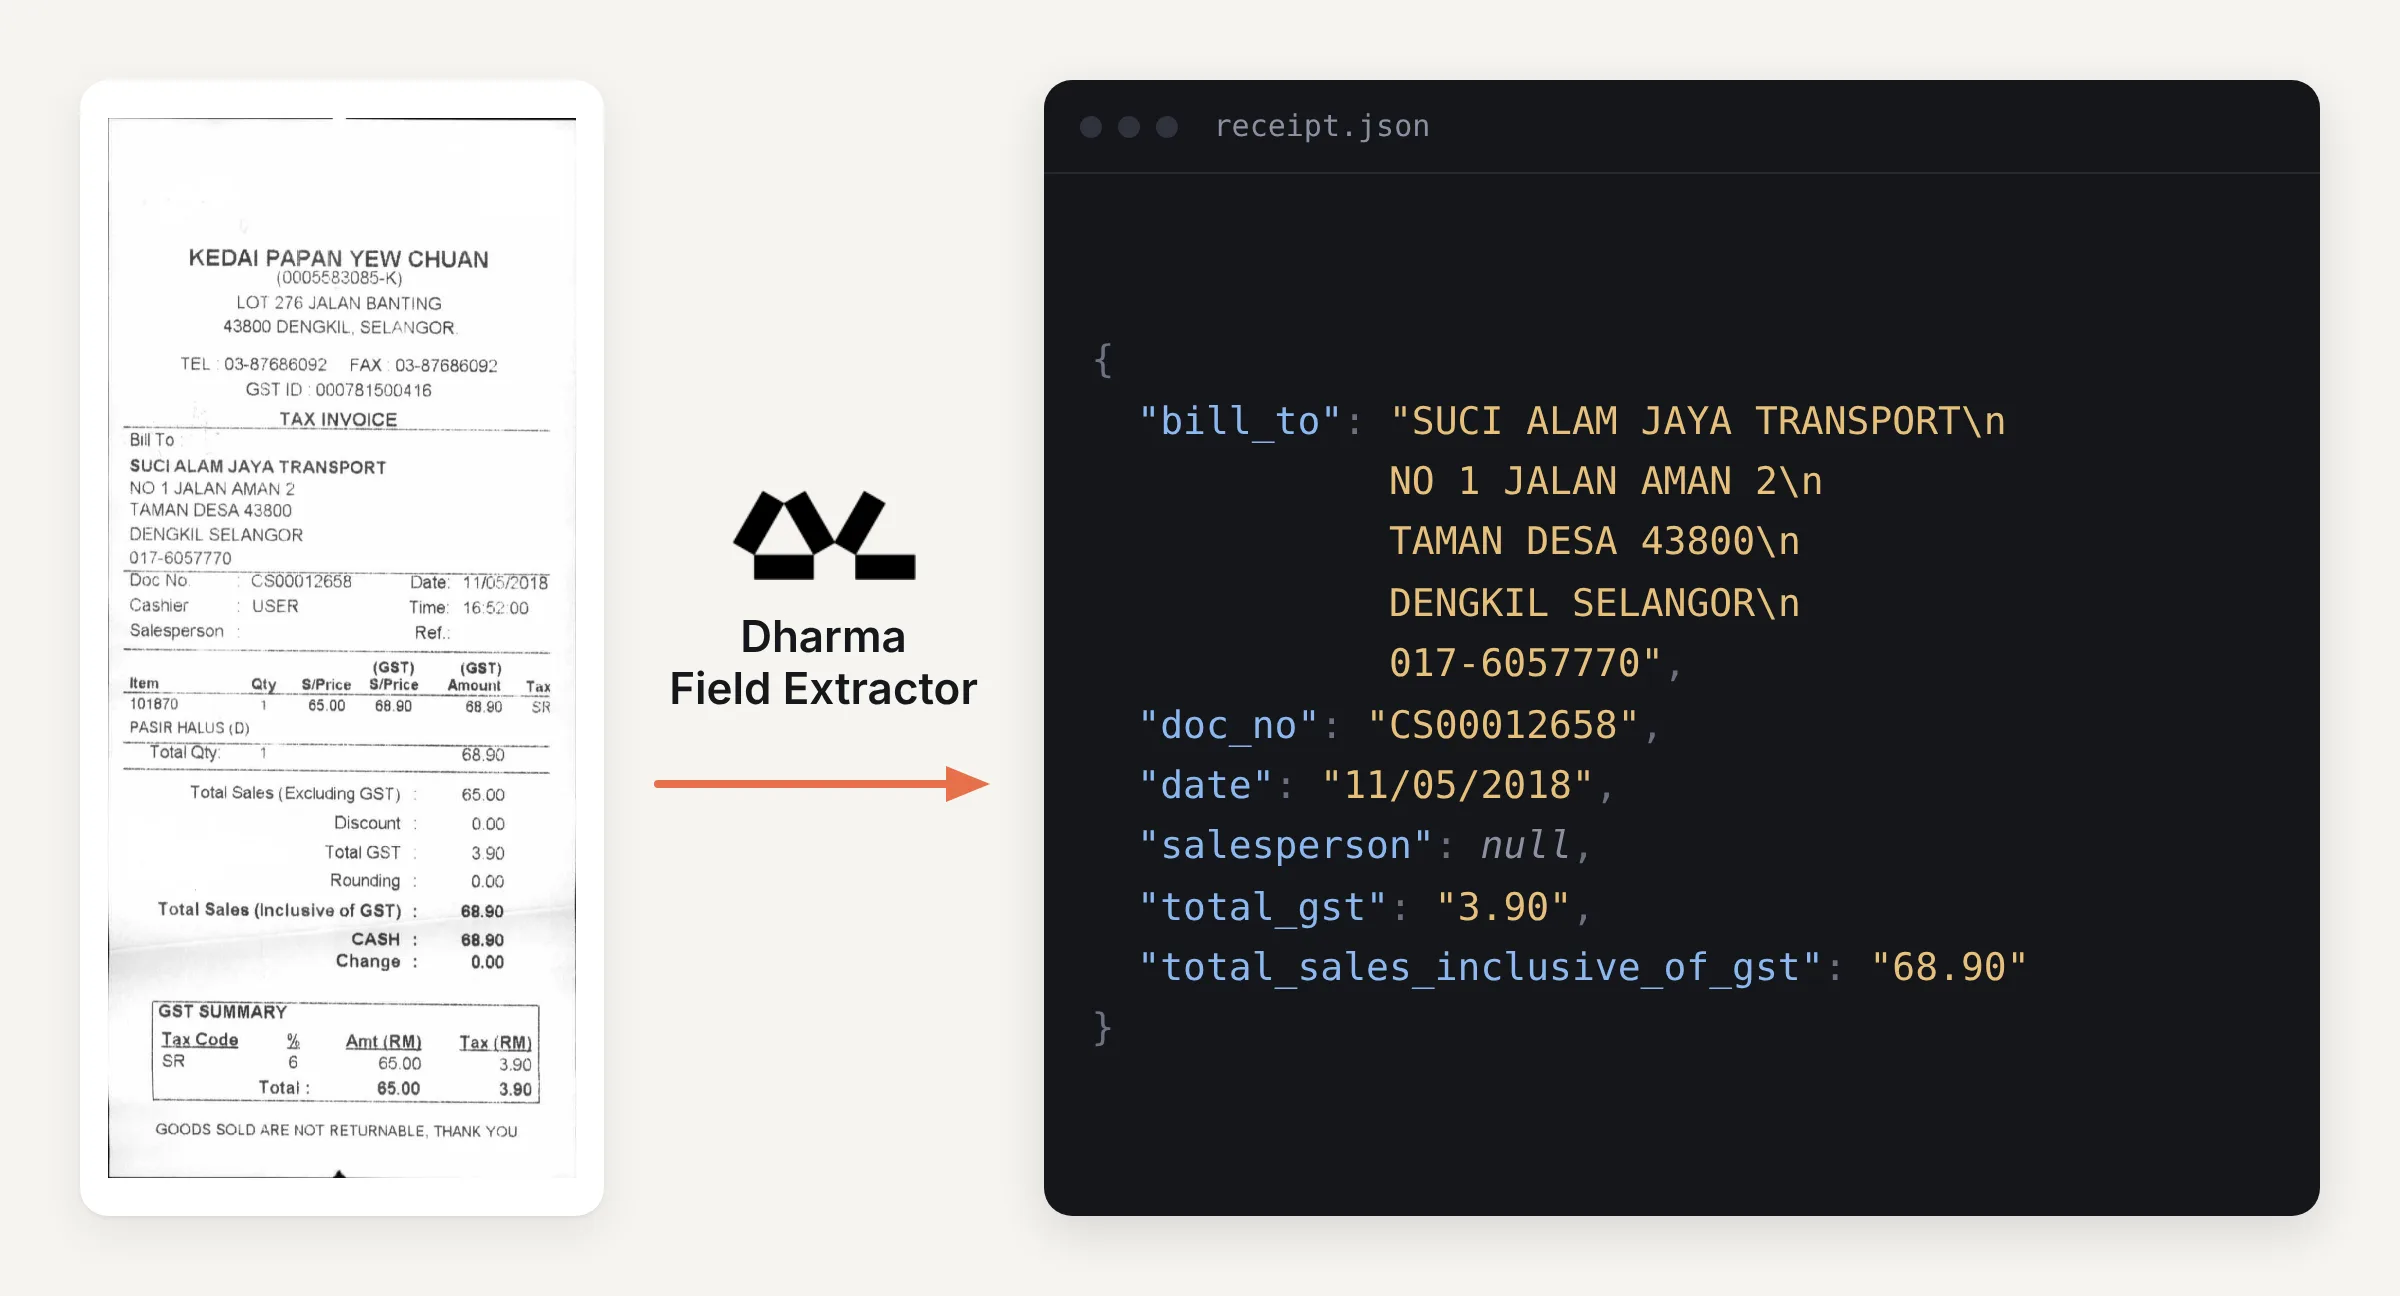
Hugging Face giới thiệu Dharma Field Extractor, một model 2 tỷ tham số được thiết kế để trích xuất chính xác các trường dữ liệu người dùng yêu cầu từ nhiều loại tài liệu. Thay vì chỉ chuyển toàn bộ trang giấy thành văn bản OCR, model trả về JSON có cấu trúc, sẵn sàng đưa vào database hoặc hệ thống xử lý tiếp theo.
Field Extractor nhận ảnh tài liệu cùng một yêu cầu mở hoặc một schema cụ thể. Với yêu cầu mở, hệ thống tìm và trả về những trường có thể nhận diện. Với schema, kết quả giữ nguyên các key được chỉ định, không thêm trường ngoài, giá trị được gán kiểu theo yêu cầu và trả về null nếu tài liệu không chứa thông tin tương ứng. Các cấu trúc lồng nhau, chẳng hạn danh sách từng dòng hàng trên hóa đơn, cũng được hỗ trợ.
Những trường hợp sử dụng được nêu gồm trích xuất nhà cung cấp, số hóa đơn, hạn thanh toán và tổng tiền; lấy tên bệnh nhân, loại xét nghiệm và ngày khám từ giấy chỉ định; hoặc đưa thông tin trên giấy tờ định danh vào hồ sơ nhân sự. Cách tiếp cận này nhằm giải quyết nhu cầu lấy một số dữ liệu cụ thể, thay vì trả lại toàn bộ nội dung trang để doanh nghiệp phải tự viết thêm logic ánh xạ.
Model nền là DharmaOCR-LITE v1.1, phiên bản 2 tỷ tham số đã được chuyên biệt hóa cho OCR bằng supervised fine-tuning và DPO. Nhóm phát triển huấn luyện thêm LoRA adapter trên 43.384 mẫu, bao phủ cả hai chế độ yêu cầu và nhiều nhóm tài liệu. Với cộng đồng AI Việt Nam, mô hình cho thấy model nhỏ, chuyên biệt có thể phù hợp hơn frontier LLM trong các quy trình tài liệu chạy khối lượng lớn.
Bài được AI biên dịch và tóm tắt từ nguồn trên. Xem bài gốc để có đầy đủ thông tin.