
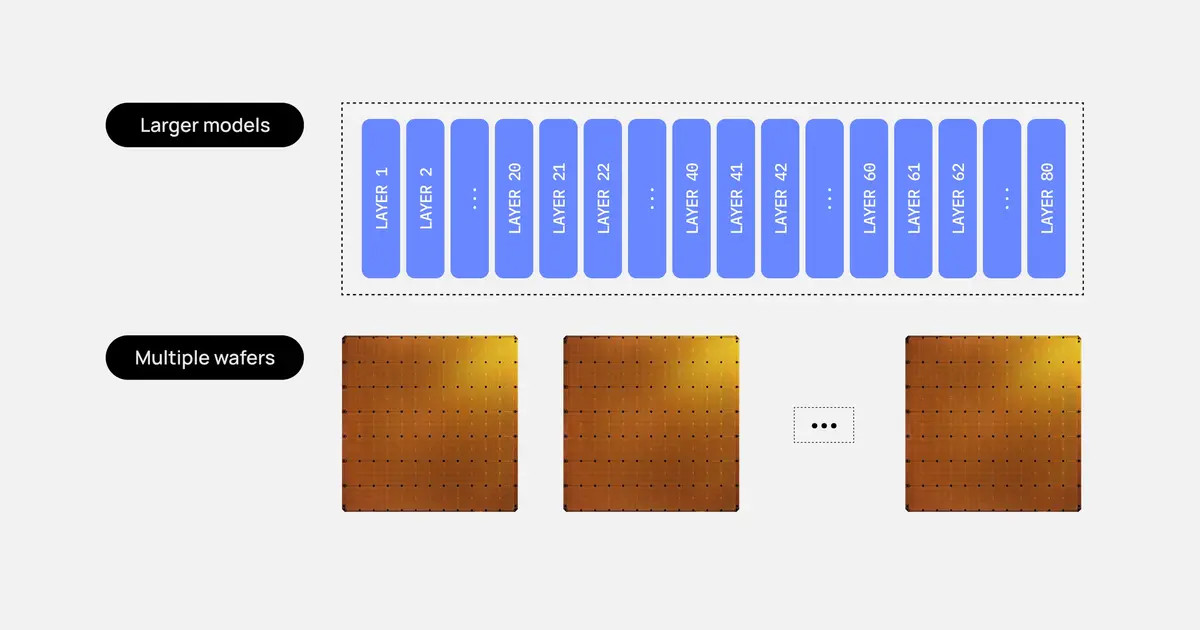
Công ty Cerebras vừa công bố cách họ triển khai các mô hình AI có quy mô hàng nghìn tỷ tham số trên chip wafer‑scale WSE‑3T, mỗi wafer sở hữu 44 GB SRAM trên chip. Để minh hoạ, họ dùng mô hình mã nguồn mở Kimi K3, với khoảng 3 tỷ tham số, 69 lớp linear‑attention và 24 lớp dense.
Kimi K3 đạt 88.3% trên Terminal‑Bench 2.1 và 91.2% trên BrowseComp, sánh ngang hoặc vượt qua các mô hình độc quyền như GPT‑5.6 Sol. Khi lưu trữ mỗi tham số ở 4 bit, khối lượng dữ liệu trọng tải khoảng 16 GB cho mỗi lớp, cho phép một lớp hoàn toàn nằm trên một wafer mà không cần chuyển tải trọng.
Hệ thống hoạt động theo kiểu pipeline: các wafer được nối bằng RDMA qua Ethernet, mỗi hop chỉ mất khoảng 2 microseconds. Chỉ các activation (kết quả trung gian) mới được truyền qua lại, trong khi trọng tải luôn cố định trên wafer. Nhờ vậy, Cerebras có thể duy trì tốc độ 1000‑2000 token/giây cho các mô hình đa‑trillion tham số.
Để tối ưu tài nguyên, pipeline luôn được lấp đầy bằng nhiều yêu cầu đồng thời (micro‑batch). Khi wafer 1 đang xử lý lớp 1‑2 cho yêu cầu A, wafer 2 có thể xử lý lớp 3‑4 cho yêu cầu B, và wafer 3 cho yêu cầu C, tạo ra hiệu suất gần như không có thời gian chờ.
Việc triển khai thành công các mô hình siêu lớn trên phần cứng wafer‑scale không chỉ mở ra khả năng chạy các LLM tiên tiến tại tốc độ thực thời, mà còn hứa hẹn giảm chi phí vận hành cho cộng đồng AI Việt Nam, giúp các nhà nghiên cứu và doanh nghiệp tiếp cận công nghệ frontier nhanh hơn.
Nguồn: Hacker News — Biên dịch & tổng hợp: danhbaai.com