
Trong phần đầu tiên của loạt bài “Profiling TorchNeuron”, chúng tôi hướng dẫn cách phân tích hiệu năng inference trên AWS Trainium bằng TorchNeuron – backend PyTorch gốc cho chip Trainium. Bài viết giả định không có kinh nghiệm profiling và bắt đầu từ những khái niệm cơ bản về cách Neuron tích hợp vào PyTorch thông qua điểm mở rộng PrivateUse1.
Để thu thập dữ liệu, chúng tôi cấu hình NeuronConfig với các ProfileMode (DEVICE, RUNTIME) và bật capture_enabled_for_nc để chỉ định các NeuronCore cần trace. Tham số correlate_device_time=True cho phép so sánh thời gian CPU và thời gian trên thiết bị trong bảng key_averages().
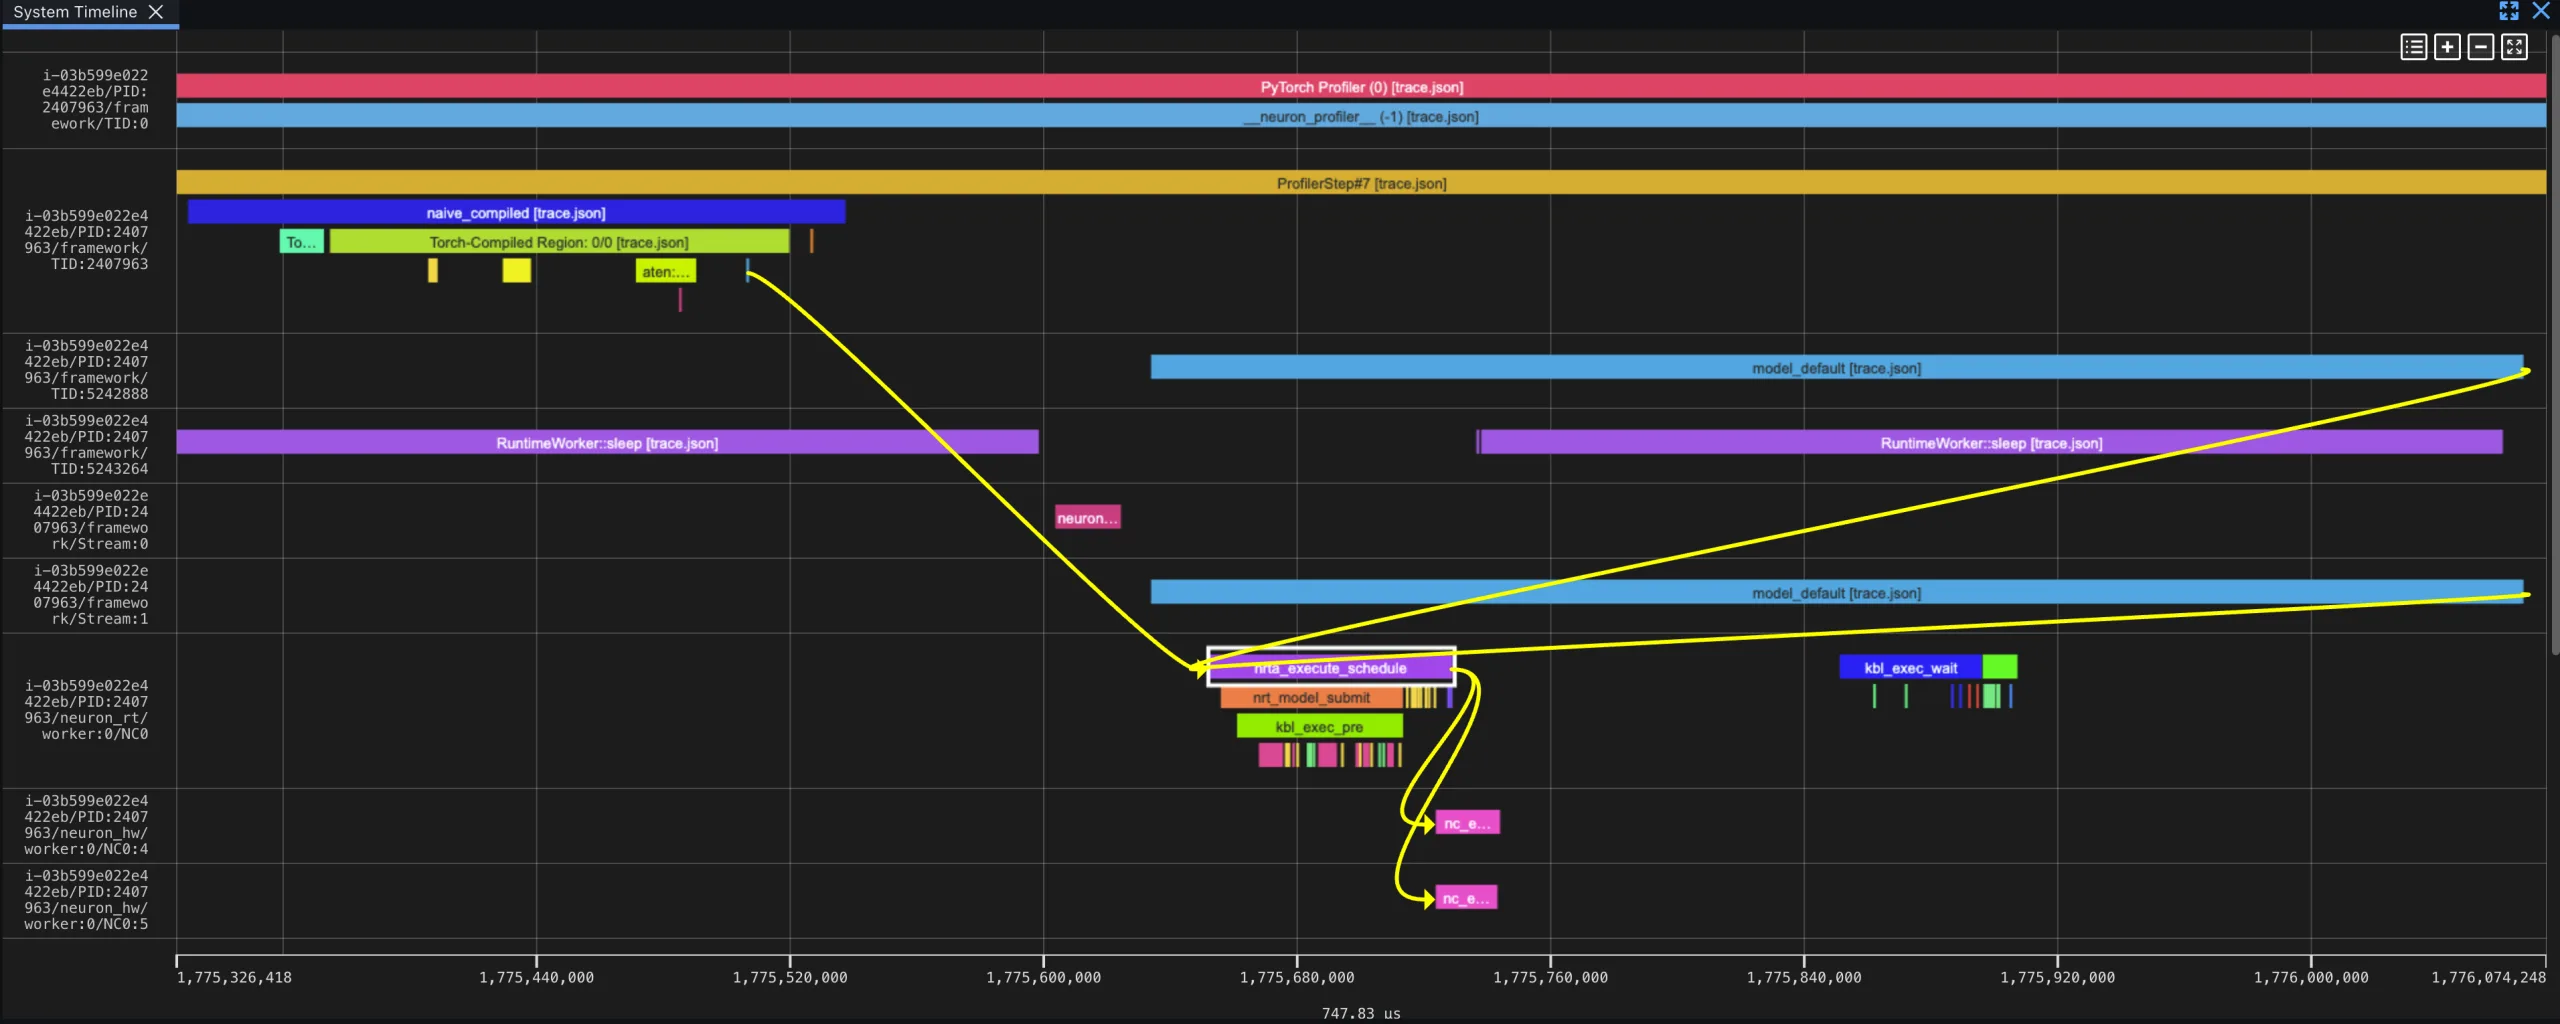
Kết quả profiling được lưu trong thư mục đầu ra, bao gồm file hệ thống trace, file .neff (Neuron Executable File Format) và file .ntff (hardware instruction trace). Các file này có cùng hash để nhận dạng cặp. Người dùng có thể mở chúng bằng Neuron Explorer – một trình xem dựa trên trình duyệt, có thể truy cập qua SSH tunnel hoặc VS Code extension – để kiểm tra timeline thiết bị và chi tiết từng engine.
Ví dụ thực tế trong bài là profiling một hàm RMSNorm nhỏ, với các script được chuẩn hoá để so sánh trực tiếp. Tất cả mã nguồn mẫu được công bố trong thư mục torch-neuronx/examples, giúp cộng đồng Việt Nam dễ dàng tái tạo và mở rộng phân tích cho các mô hình lớn hơn.
Việc nắm vững profiling trên Trainium sẽ giúp các nhà phát triển AI trong nước tối ưu chi phí và thời gian inference, đồng thời khai thác tối đa sức mạnh phần cứng mới của AWS.
Nguồn: Hugging Face — Biên dịch & tổng hợp: danhbaai.com