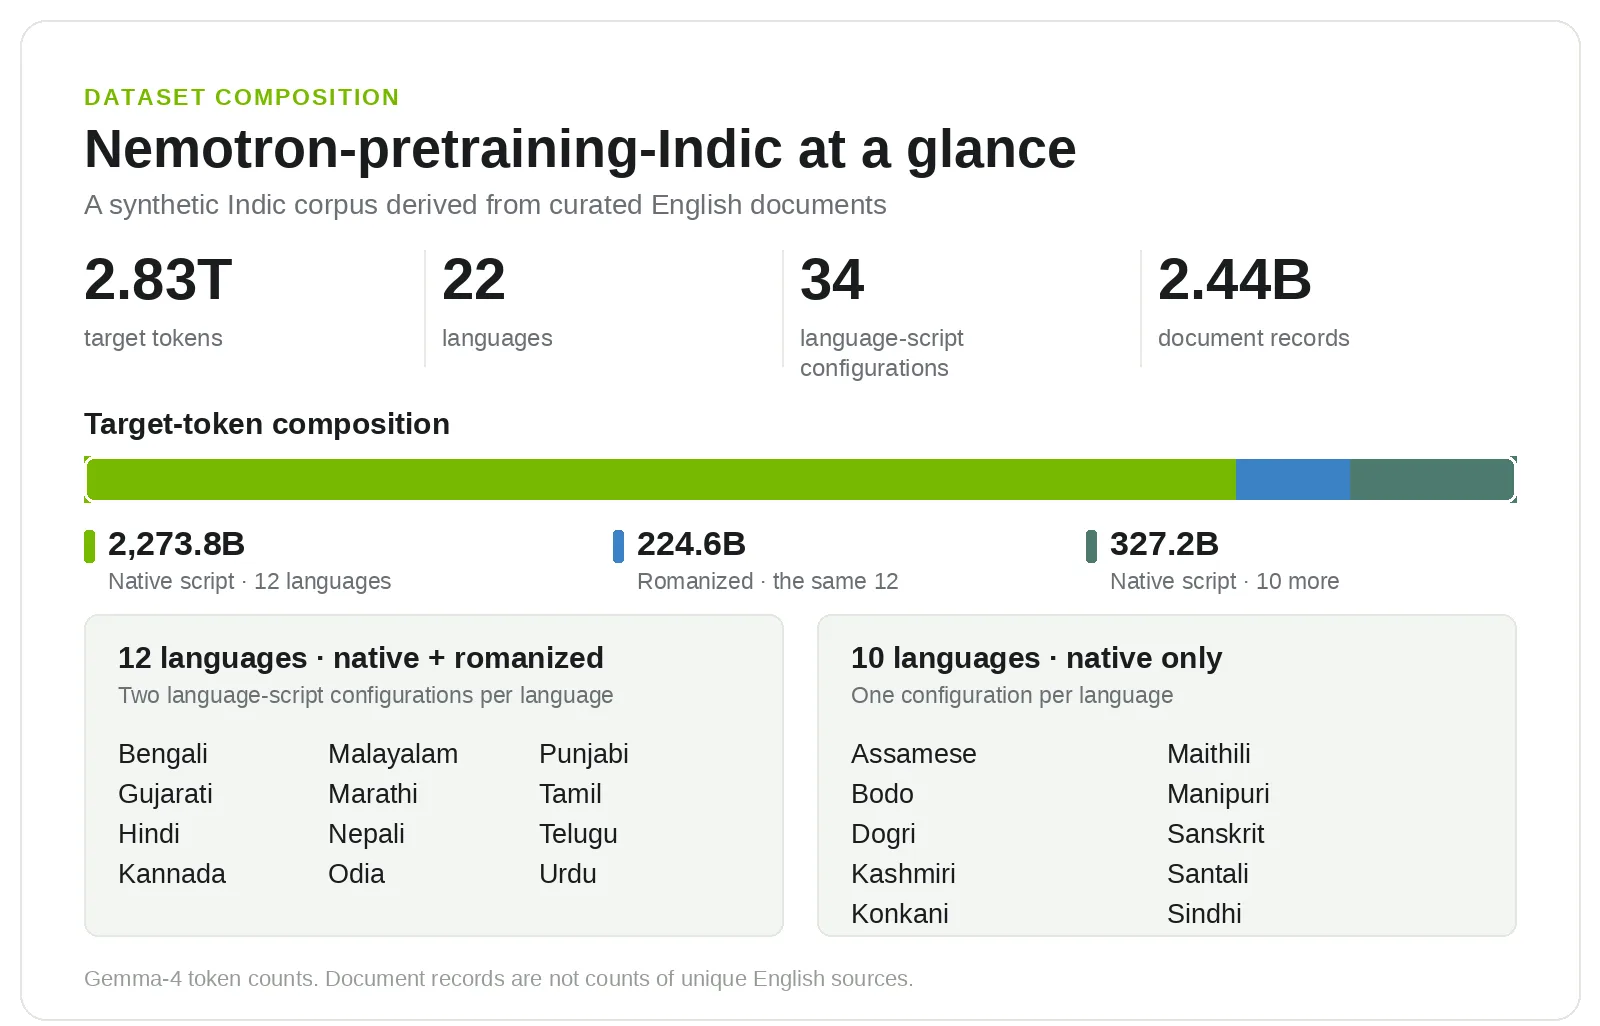
NVIDIA vừa phối hợp với viện công nghệ IIT Madras và phòng nghiên cứu AI4Bharat ra mắt bộ dữ liệu Nemotron-pretraining-Indic-v1, chứa khoảng 2,8 nghìn tỷ token bao gồm 22 ngôn ngữ chính thức tại Ấn Độ. Dự án này nhằm giải quyết bài toán thiếu hụt dữ liệu huấn luyện trầm trọng đối với các ngôn ngữ khu vực Nam Á so với tiếng Anh.
Bộ dữ liệu bao gồm cả văn bản dạng chữ viết bản địa lẫn chữ Latinh (romanized), kết hợp cùng tài liệu tiếng Anh đã qua kiểm duyệt về toán học, mã nguồn và hỏi đáp. Điểm nổi bật là nhóm phát triển cũng chia sẻ một pipeline tạo dữ liệu tăng tốc bằng GPU, cho phép các lập trình viên tự động hóa quy trình dịch thuật, đánh giá chất lượng và sửa lỗi để mở rộng nguồn tài nguyên.
Sự kiện này đánh dấu bước tiến quan trọng trong việc thu hẹp khoảng cách công nghệ ngôn ngữ giữa các quốc gia. Đối với cộng đồng AI tại Việt Nam, mô hình hợp tác giữa cơ quan nghiên cứu học thuật và ông lớn phần cứng như NVIDIA mở ra bài học quý giá trong việc xây dựng các tập dữ liệu pretraining chất lượng cao cho tiếng Việt và các ngôn ngữ có nguồn tài nguyên hạn chế.
Nguồn: Hugging Face — Biên dịch & tổng hợp: danhbaai.com