
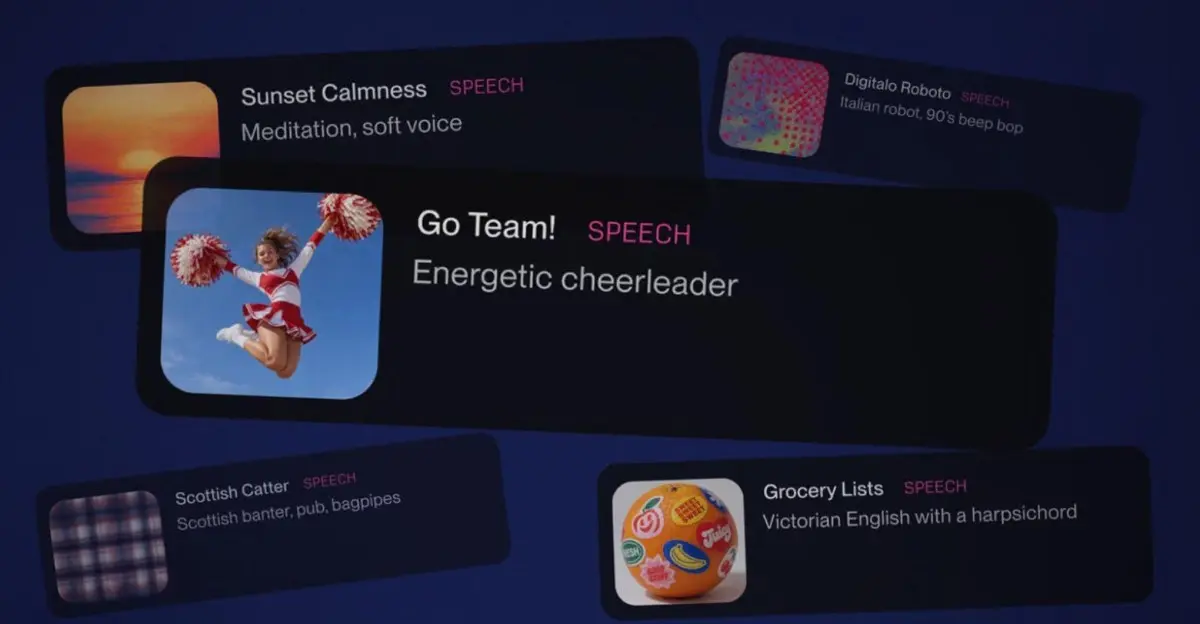
Suno, nền tảng tạo nhạc bằng AI phổ biến, vừa ra mắt tính năng mới mang tên Speech ở phiên bản thử nghiệm rộng rãi (public beta) trên cả ứng dụng web và di động. Đáng chú ý, đây là mô hình audio cho phép tạo ra giọng đọc lồng tiếng (voiceover) đồng thời với nhạc nền phù hợp trong cùng một bản thu thống nhất.
Theo đại diện của Suno, tính năng Speech được thiết kế nhằm mang lại trải nghiệm âm thanh toàn diện hơn. Người dùng vẫn có thể tắt nhạc nền bằng một thao tác chuyển đổi đơn giản nếu chỉ cần file đọc sạch. Tính năng này hỗ trợ hai chế độ tạo âm thanh chính:
- Simple: Tạo giọng đọc dựa trên câu lệnh prompt mô tả bối cảnh (ví dụ: lời kêu gọi của một thuyền trưởng cướp biển).
- Advanced: Cho phép nhập trực tiếp kịch bản văn bản chi tiết, lựa chọn giới tính giọng đọc, phong cách diễn đạt và độ biến thiên của âm thanh. Thời lượng bản thu tối đa lên tới 8 phút.
Dù thị trường text-to-speech đã có sự tham gia của các tên tuổi lớn như ElevenLabs hay Adobe, Suno vẫn tạo dấu ấn riêng bằng việc tự động phối nhạc nền phù hợp với tâm trạng của lời đọc. Công ty cũng thừa nhận sản phẩm đang ở giai đoạn thử nghiệm nên có thể phát sinh một số lỗi nhỏ về chất giọng hoặc nhịp ngắt câu.
Sự xuất hiện của Suno Speech hứa hẹn sẽ mang đến công cụ hữu ích cho cộng đồng sáng tạo nội dung, làm podcast và tiếp thị tại Việt Nam trong việc tối ưu hóa quy trình sản xuất âm thanh chuyên nghiệp.
Nguồn: The Verge — Biên dịch & tổng hợp: danhbaai.com