
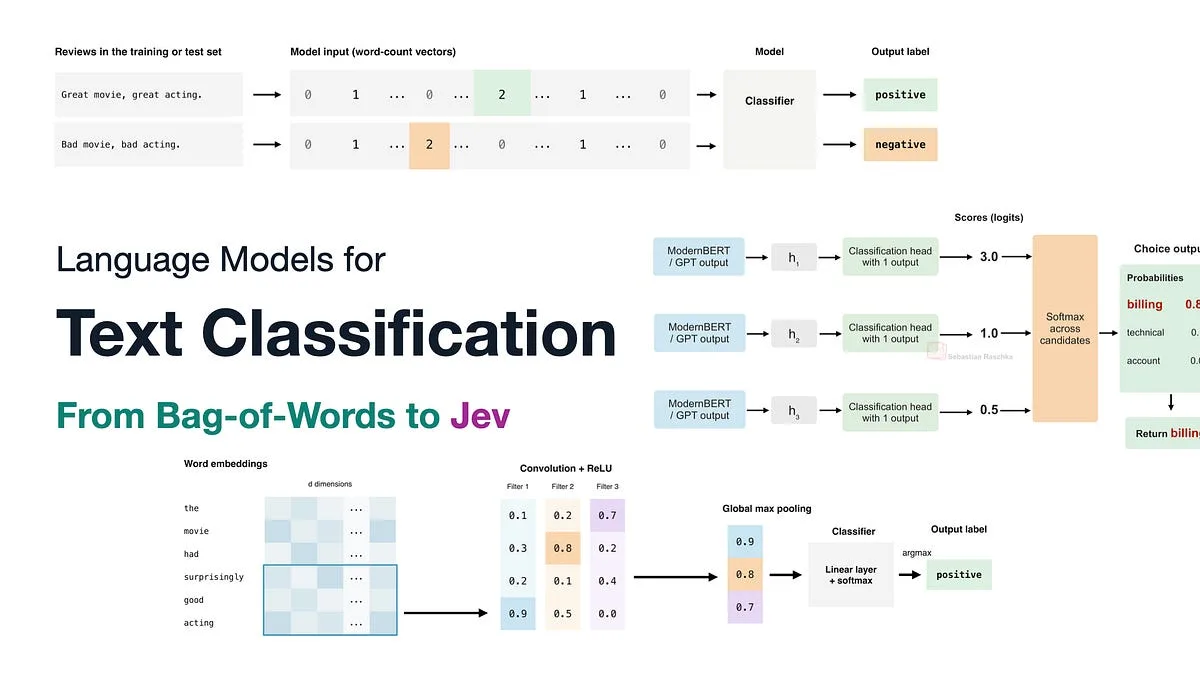
Sebastian Raschka, nhà nghiên cứu AI nổi tiếng, vừa công bố bài phân tích chuyên sâu về lịch sử các language model dùng cho text classification, từ phương pháp Bag-of-Words cổ điển đến model Jev – hiện tượng đang gây sốt trong cộng đồng kỹ thuật suốt hai tuần qua.
Bài viết đi qua toàn bộ hành trình phát triển: bắt đầu từ Bag-of-Words kết hợp Naive Bayes, Logistic Regression – phương pháp phổ biến cách đây 15 năm khi Raschka còn là nghiên cứu sinh. Tiếp đến là các kiến trúc deep learning như RNN, CNN, rồi Transformer đã thay đổi hoàn toàn cục diện. Cuối cùng là Jev, model phân loại mới nhất đang thu hút sự chú ý lớn.
Theo Raschka, Jev chiếm vị trí đặc biệt trong hệ sinh thái AI hiện tại. So với các LLM tiên tiến như GPT hay các open-weight model, Jev xử lý bài toán classification nhanh hơn và rẻ hơn đáng kể, dù không có khả năng suy luận tổng quát. Ngược lại, so với các classifier chuyên biệt cho từng tác vụ hẹp, Jev không nhất thiết tốt hơn nhưng lại linh hoạt hơn nhiều nhờ khả năng tổng quát hóa.
Raschka nhấn mạnh rằng Jev “không chỉ là một text classifier đơn thuần” mà cũng “về bản chất vẫn là text classifier”. Bài viết cũng đề cập đến calibration và các API kiểu Jev, giúp người đọc hiểu rõ phương pháp luận đằng sau sản phẩm này.
Đối với cộng đồng AI Việt Nam, bài phân tích này là tài liệu tham khảo giá trị để hiểu bối cảnh lịch sử của text classification và đánh giá đúng vị trí của các công cụ mới như Jev trong thực tế triển khai.
Nguồn: Hacker News — Biên dịch & tổng hợp: danhbaai.com